
Knowledge Base 벡터 저장소 선택과 에이전트 Retrieve 연동
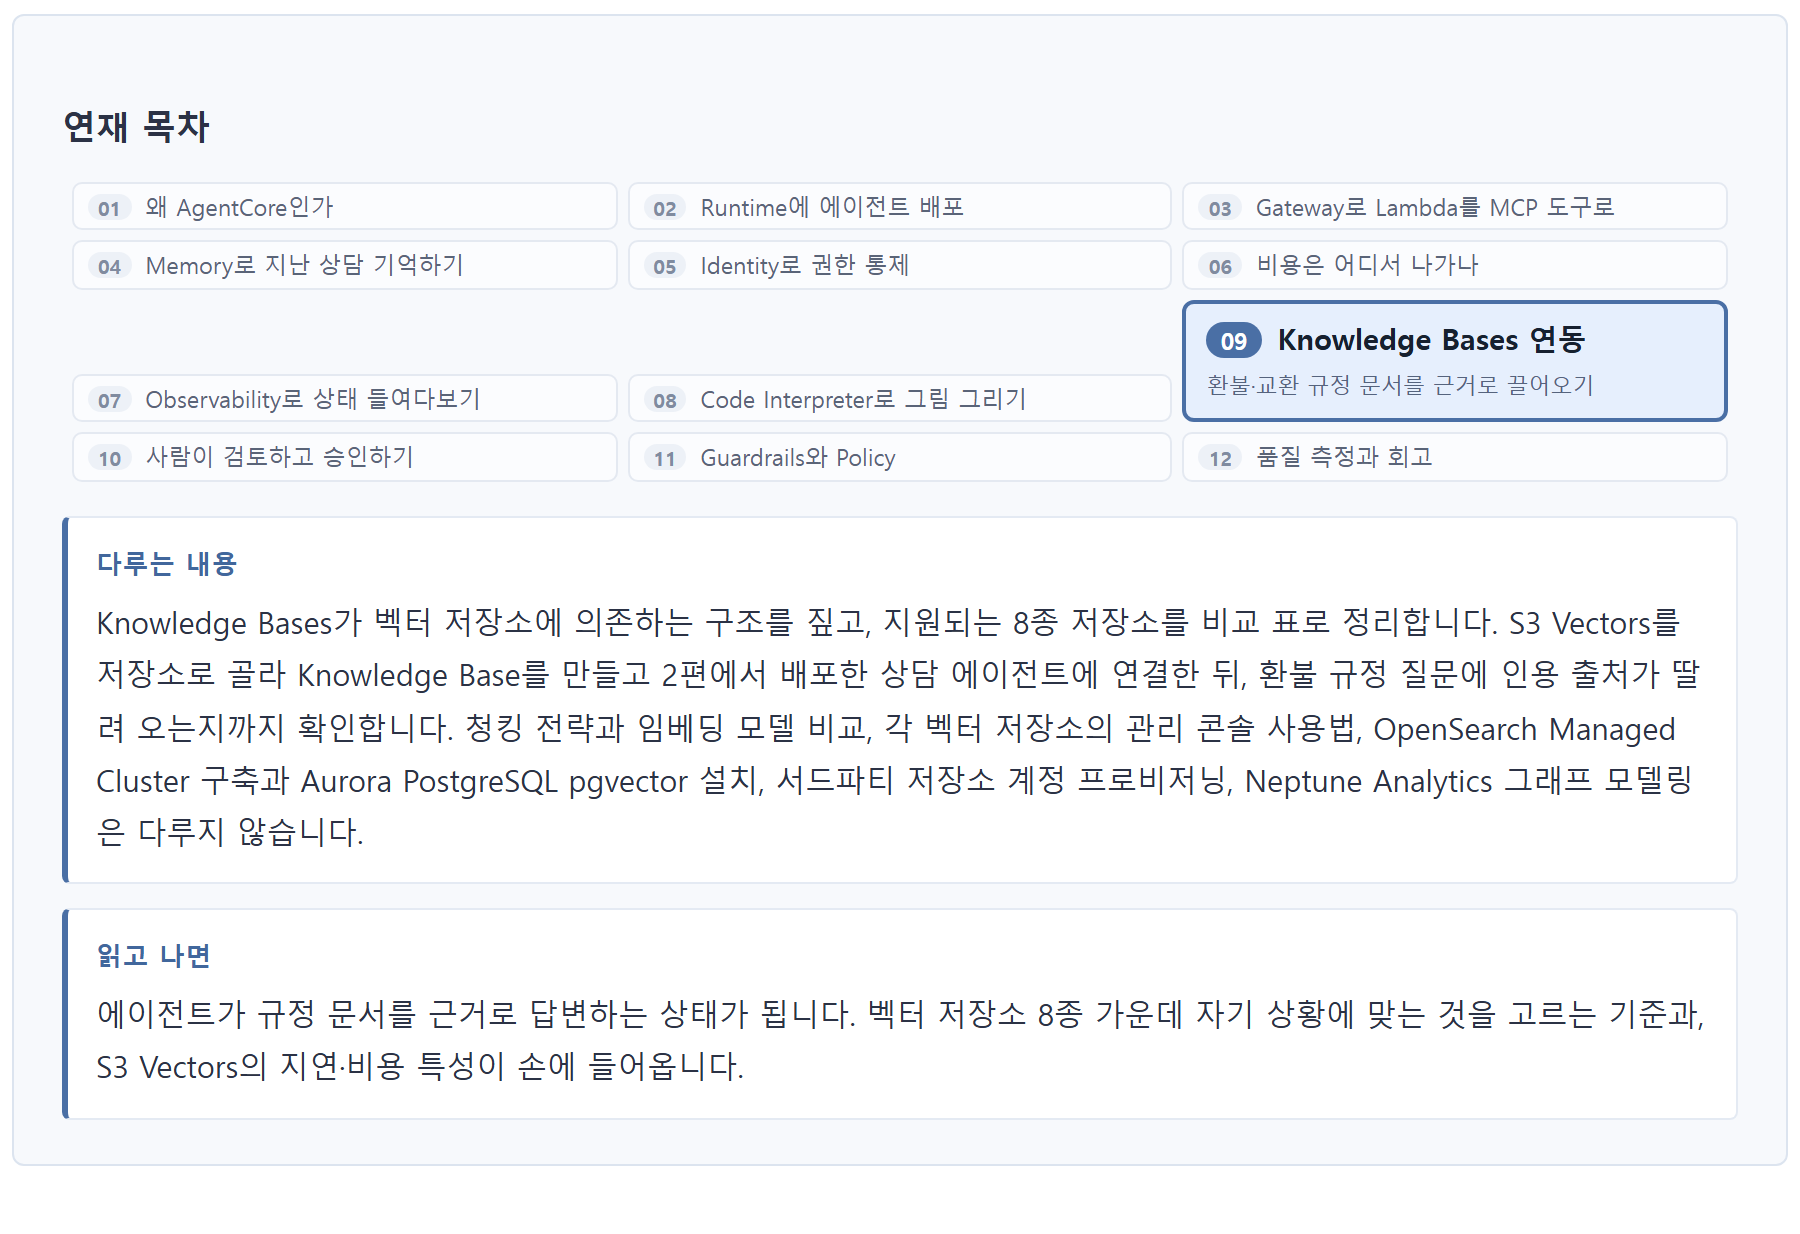
"이 셔츠 환불되나요? 산 지 열흘 됐는데요." 고객이 묻습니다. 3편에서 연결한 주문 조회 도구로 주문 내역은 꺼낼 수 있지만, 환불이 되는지 여부는 주문 데이터에 없습니다. 답은 환불·교환 규정 문서에 있고, 그 문서는 시즌마다 바뀝니다.
에이전트 코드에 규정을 하드코딩하면 문서가 바뀔 때마다 재배포해야 합니다. 규정이 한두 페이지일 때는 시스템 프롬프트에 넣어도 되지만, 배송 정책·멤버십 약관·프로모션 조건까지 합치면 토큰 한도를 금방 넘깁니다. 그러면 에이전트는 규정을 모르는 상태로 답하거나, 있지도 않은 규정을 지어내기 시작합니다.
Knowledge Bases는 이 문제를 풀어 줍니다. 규정 문서를 벡터로 쪼개 저장해 두면, 에이전트가 질문과 관련된 조각만 골라 꺼내 근거로 씁니다. 문서가 바뀌면 다시 수집하면 되고 에이전트 코드는 손대지 않습니다. 그런데 Knowledge Bases를 만들 때 가장 먼저 부딪히는 선택이 벡터 저장소입니다. 8종이 지원되고, 고른 저장소에 따라 비용과 지연과 운영 부담이 크게 달라집니다.
3줄 요약
- Knowledge Bases는 벡터 저장소 8종을 지원하며, 저장소 선택이 최소 과금·쿼리 지연·운영 부담을 좌우합니다.
- 서버리스로 빠르게 시작하려면 S3 Vectors가 낫습니다. 별도 클러스터 없이 버킷과 인덱스만 만들면 되고, warm 쿼리 지연은 100ms 수준입니다.
- 저장소를 직접 고르면 Agentic retrieval과 Gateway 연동을 못 씁니다. Retrieve 요금은 1,000건당 $1.00이고 호출 횟수에 정비례하므로, 한 문의에 몇 번 부를지 설계합니다.
검증 환경
1. 왜 벡터 저장소 선택이 중요한가
Knowledge Bases는 문서를 직접 들고 있지 않습니다. 문서를 청크로 쪼개고 임베딩 벡터로 변환한 뒤, 그 벡터를 외부 저장소에 넣어 둡니다. 에이전트가 Retrieve를 호출하면 Knowledge Bases가 질문을 벡터로 바꿔 저장소에 유사도 검색을 보내고, 돌아온 청크를 에이전트에 넘깁니다. 저장소가 느리면 답변이 느리고, 저장소가 비싸면 Knowledge Bases를 쓰는 비용 전체가 올라갑니다.
문제는 저장소마다 과금 구조가 다르다는 점입니다. OpenSearch Serverless Classic 컬렉션은 아무 쿼리가 없어도 최소 2 OCU가 시간 단위로 과금됩니다. 반면 S3 Vectors는 쿼리 건수와 저장 용량에 비례해 과금되므로 트래픽이 적을 때 비용이 낮습니다. 지연도 갈립니다. S3 Vectors의 warm 쿼리는 100ms 수준이고, cold 쿼리는 서브초(1초 미만)입니다. OpenSearch Serverless는 OCU를 늘리면 지연이 줄지만 그만큼 비용이 따라옵니다.
저장소를 나중에 바꾸려면 Knowledge Base를 새로 만들고 문서를 다시 수집해야 합니다. 처음에 고르는 것이 중요한 이유입니다.
2. 아키텍처 — Knowledge Bases와 벡터 저장소의 관계
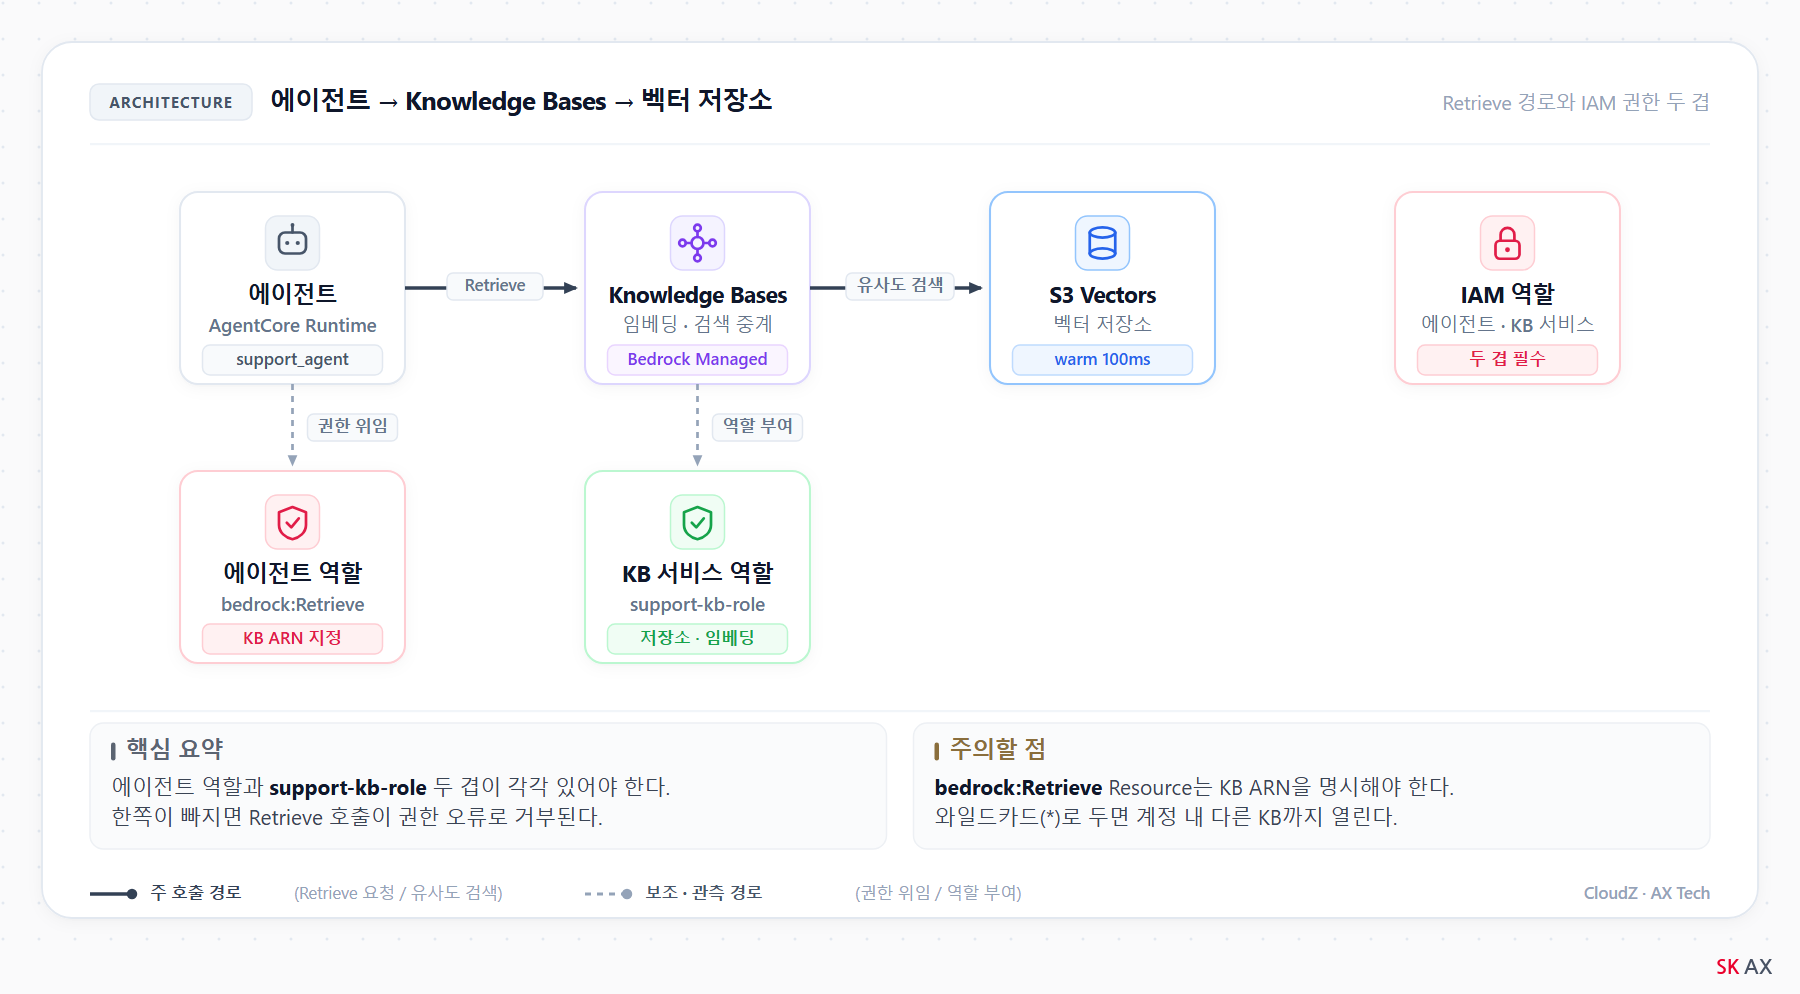
[그림 1] 에이전트 → Knowledge Bases → 벡터 저장소 호출 구조 — Retrieve 요청이 거치는 구성요소와 IAM 권한 경계
에이전트가 환불 규정을 찾는 흐름은 세 단계를 거칩니다. 먼저 에이전트가 Bedrock의 Retrieve API를 호출합니다. Knowledge Bases가 질문 텍스트를 임베딩 모델에 보내 벡터로 바꾸고, 그 벡터를 벡터 저장소에 유사도 검색으로 넘깁니다. 저장소가 가장 가까운 청크를 돌려주면 Knowledge Bases가 그 청크와 출처 정보를 에이전트에 반환합니다.
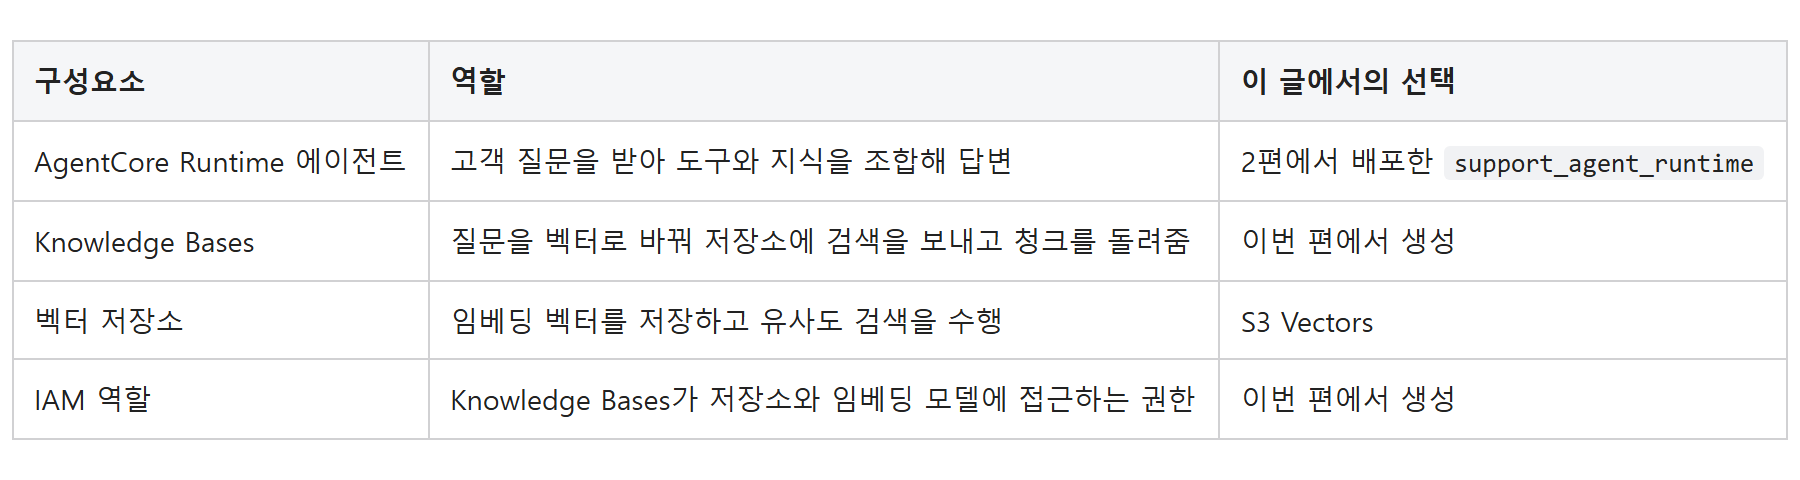
에이전트가 Knowledge Bases를 호출하려면 bedrock:Retrieve 권한이 필요합니다. 이 권한의 Resource ARN 형식은 arn:aws:bedrock:{region}:{account-id}:knowledge-base/{KnowledgeBaseId}입니다. 그런데 Knowledge Bases 자체도 벡터 저장소에 벡터를 읽고 쓰는 권한과 임베딩 모델을 호출하는 권한이 별도로 필요합니다. 4.2절에서 만드는 support-kb-role이 그 역할입니다. 에이전트 역할과 Knowledge Bases 서비스 역할이 각각 따로 필요하므로 IAM 역할이 두 겹으로 걸립니다. 어느 한쪽이 빠지면 Retrieve 호출이 권한 오류로 거부됩니다.
3. 저장소 8종 비교와 선택 기준
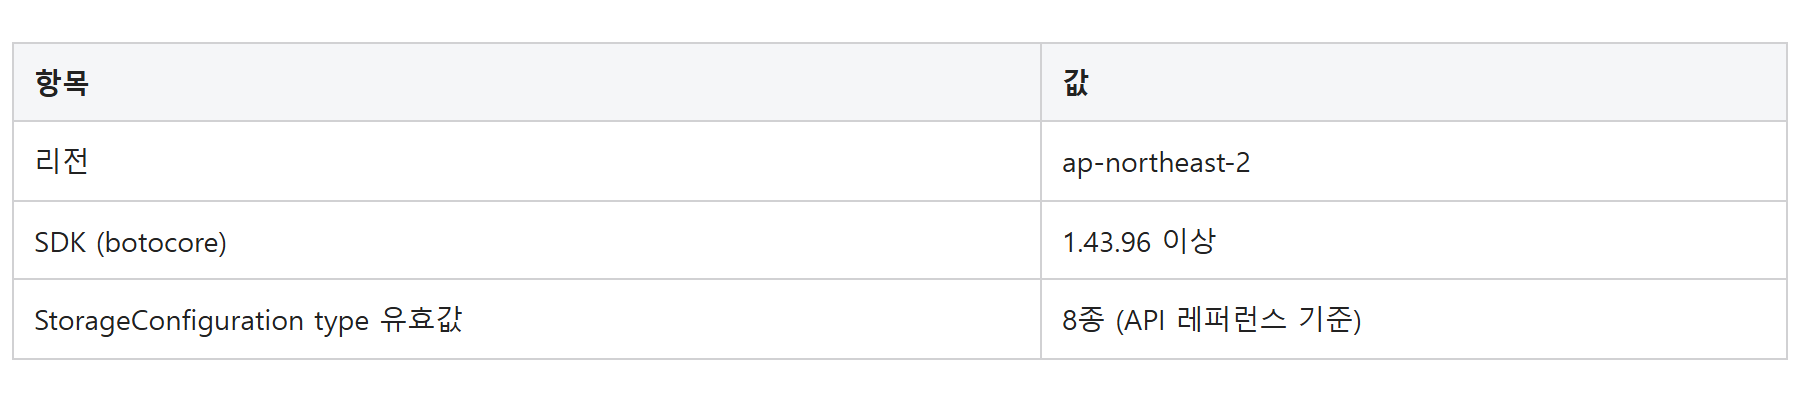
Knowledge Bases의 StorageConfiguration API는 type 파라미터로 8가지 저장소를 받습니다.
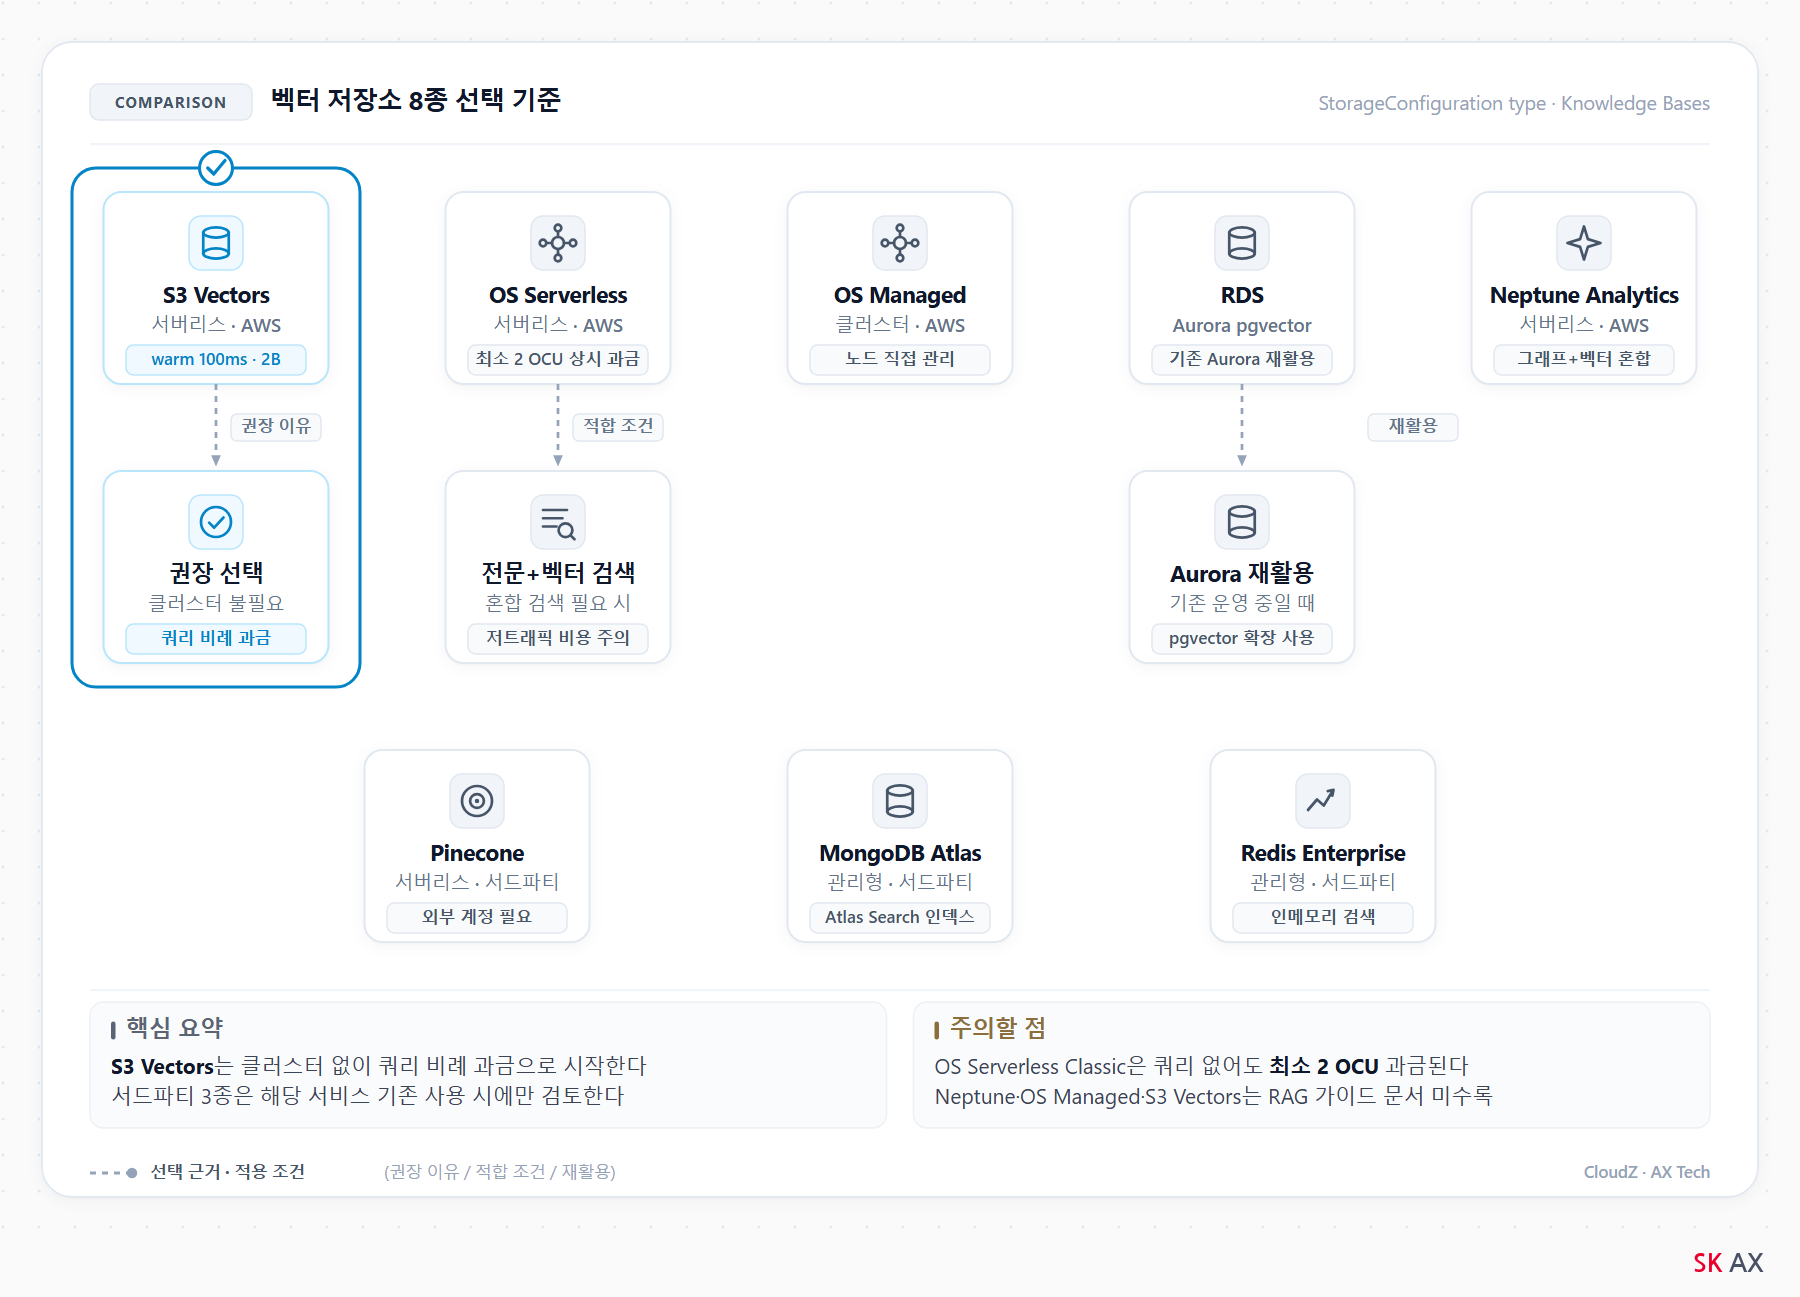
[그림 2] 벡터 저장소 8종 선택 기준 — 서버리스 여부, fieldMapping 필요 여부, 최소 비용, 관리 주체
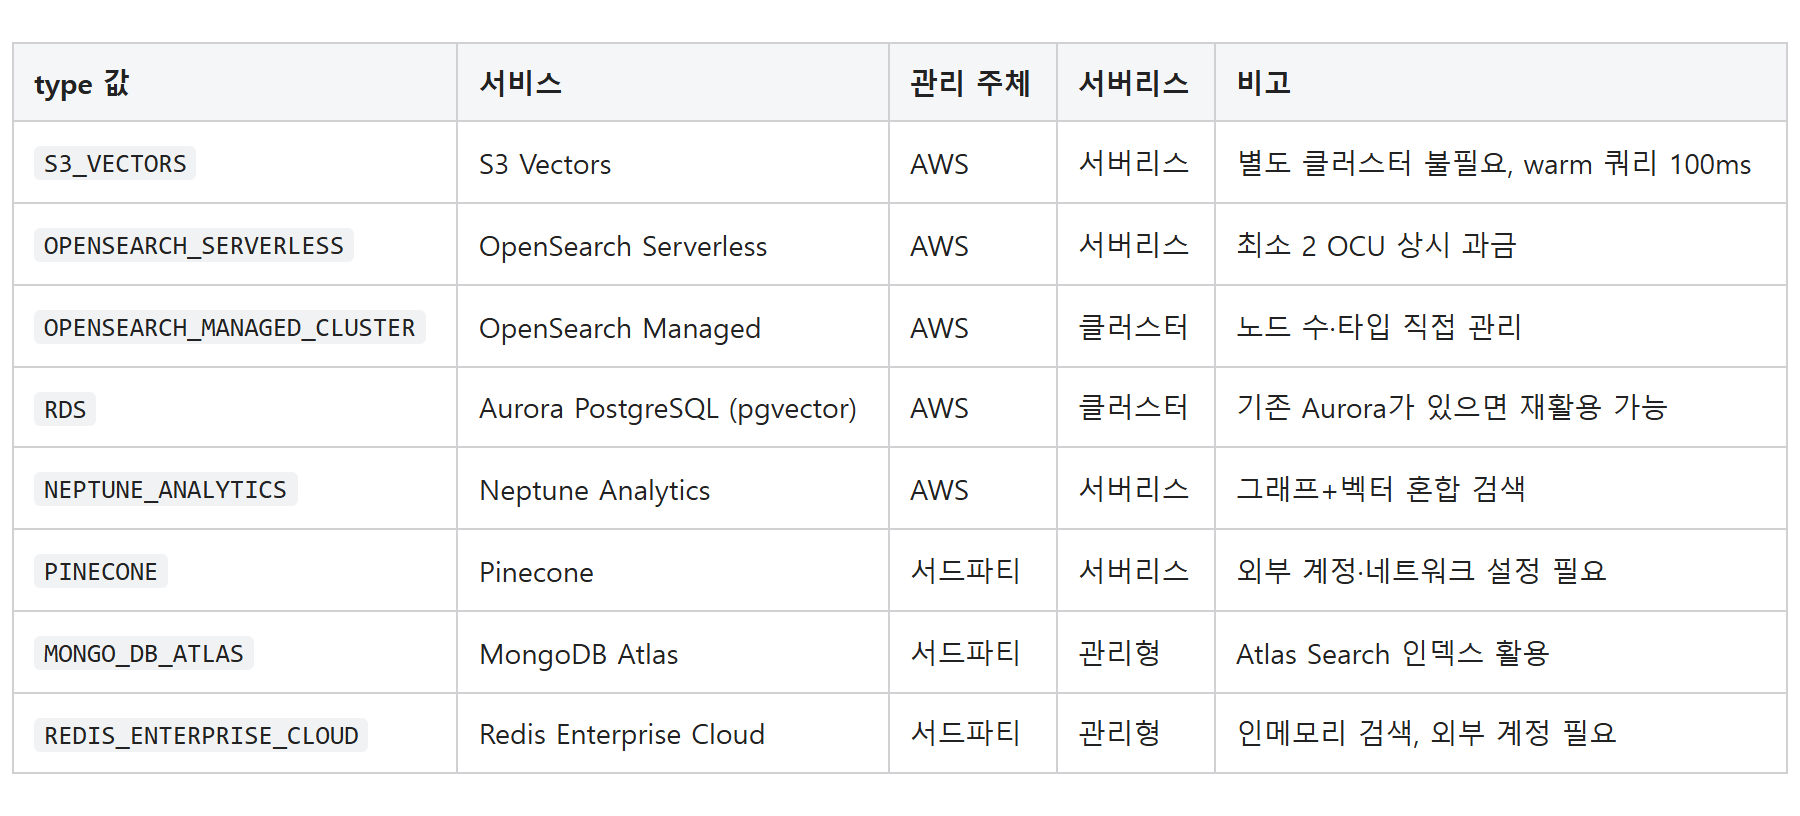
Neptune Analytics, OpenSearch Managed Cluster, S3 Vectors는 AWS의 RAG 옵션 가이드 문서에는 아직 나열되어 있지 않지만, API 레퍼런스의 StorageConfiguration type 유효값에는 포함되어 있습니다.
위 8종은 모두 customer-managed Knowledge Base의 선택지입니다. 저장소를 직접 고른다는 것이 그 뜻입니다. Bedrock에는 저장소까지 서비스가 맡는 managed Knowledge Base도 있는데, 그쪽을 고르면 저장소를 고르지 않습니다. 둘은 쓸 수 있는 기능이 다릅니다.
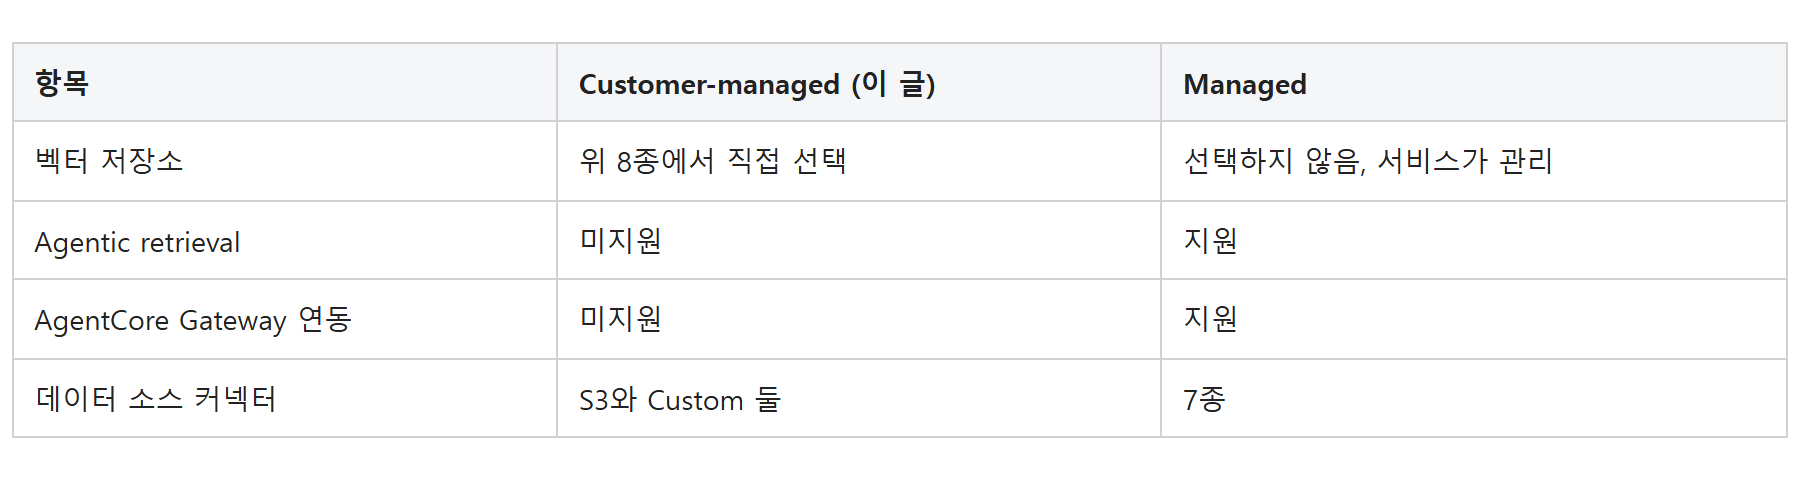
이 글은 저장소 선택과 비용 통제를 다루므로 customer-managed로 갑니다. 대가는 Agentic retrieval과 Gateway 연동입니다. 에이전트가 질의를 스스로 계획해 여러 지식 베이스를 넘나들게 하려면 managed를 골라야 하고, 그때는 저장소 8종 비교가 의미를 잃습니다. 4.5절에서 에이전트를 붙일 때 Gateway를 쓰지 않는 까닭도 여기에 있습니다.
S3 Vectors를 권장합니다. 이유는 셋입니다. 별도 클러스터나 컬렉션을 프로비저닝하지 않아도 되고, 인덱스당 최대 벡터 수가 20억 개라 규모 걱정이 없으며, 쿼리 건수 비례 과금이라 트래픽이 적을 때 비용이 거의 나가지 않습니다.
OpenSearch Serverless는 전문 검색과 벡터 검색을 함께 써야 할 때 고릅니다. 다만 Classic 컬렉션은 쿼리가 없어도 최소 2 OCU가 시간 단위로 과금되므로, 트래픽이 낮은 환경에서는 비용이 S3 Vectors보다 높습니다. 기존에 Aurora PostgreSQL을 운영 중이라면 RDS 타입으로 pgvector를 재활용하는 것도 방법이지만, 이 글에서는 다루지 않습니다. 서드파티 세 종은 이미 해당 서비스를 쓰고 있을 때만 검토합니다.
4. 구현 — S3 Vectors 저장소로 Knowledge Base 만들고 에이전트에 연결하기
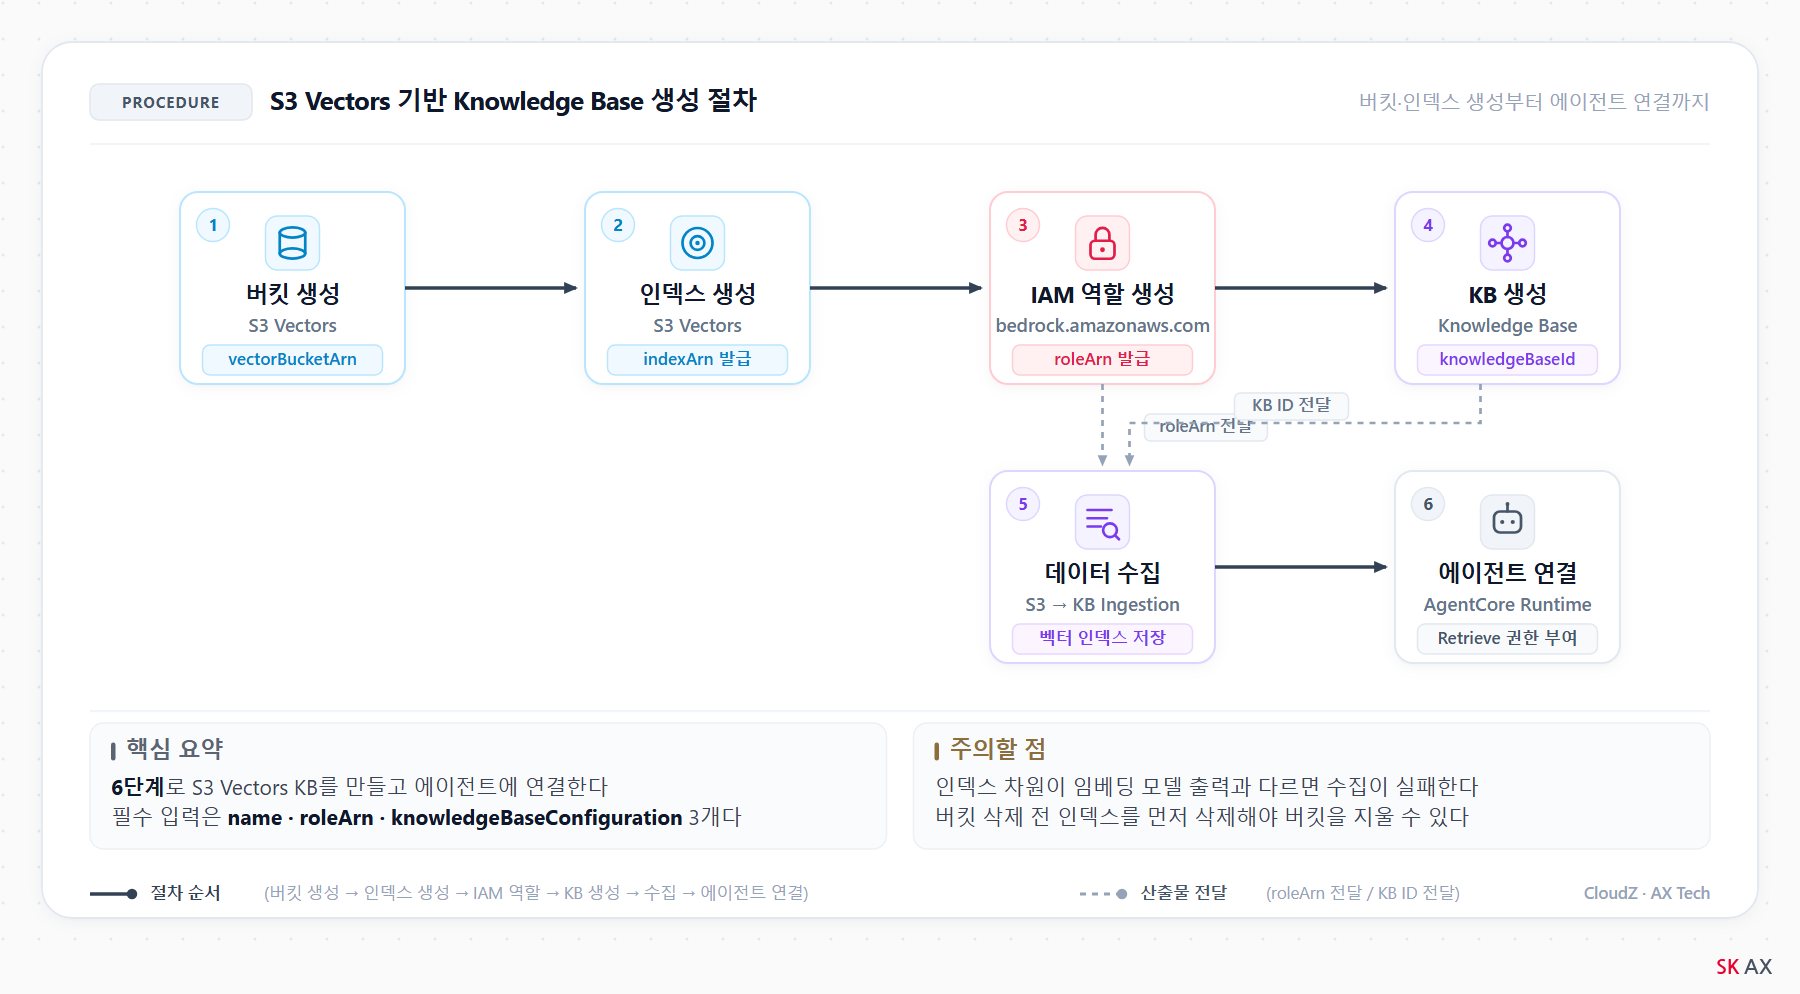
[그림 3] S3 Vectors 기반 Knowledge Base 생성 절차 — 버킷·인덱스 생성부터 에이전트 연결까지 단계별 생성 리소스
이번 절에서 만드는 리소스는 S3 Vectors 버킷, 벡터 인덱스, IAM 역할, Knowledge Base, 데이터 소스이고, 마지막에 2편의 에이전트와 연결합니다. 아래 변수를 먼저 선언해 둡니다. <your-account-id>는 AWS 계정 ID이고, aws sts get-caller-identity --query 'Account' --output text로 확인됩니다. <your-region>은 Knowledge Bases와 S3 Vectors가 지원되는 리전이며, AWS 문서에서 확인하고 설정합니다.
ACCOUNT=<your-account-id>
REGION=<your-region>
VB_NAME=support-kb-vectors
INDEX_NAME=support-refund-index
KB_NAME=support-refund-kb
KB_ROLE_NAME=support-kb-role
AGENT_ROLE_NAME=support-agent-runtime-role
RUNTIME_ID=<2편에서-얻은-agentRuntimeId>
EMB_MODEL=amazon.titan-embed-text-v2:0
EMB_DIM=1024
AGENT_ROLE_NAME은 2편에서 만든 Runtime 실행 역할 이름이고, RUNTIME_ID는 create-agent-runtime 응답의 agentRuntimeId입니다. 잊었다면 아래 명령으로 다시 찾습니다.
aws bedrock-agentcore-control list-agent-runtimes \
  --query 'agentRuntimes[?agentRuntimeName==
    `support_agent_runtime`].agentRuntimeId' \
  --output text
4.1 S3 Vectors 버킷과 인덱스 만들기
S3 Vectors 버킷은 일반 S3 버킷과 다릅니다. 벡터 전용 버킷이고, 그 안에 인덱스를 만들어야 벡터를 넣을 수 있습니다. 버킷이 그릇이라면 인덱스는 그 안의 선반입니다.
aws s3vectors create-vector-bucket \
  --vector-bucket-name "${VB_NAME}"
응답에 vectorBucketArn이 돌아옵니다. 이 값은 IAM 정책에서 쓰므로 변수에 담아 둡니다.
VB_ARN=$(aws s3vectors get-vector-bucket \
  --vector-bucket-name "${VB_NAME}" \
  --query 'vectorBucket.vectorBucketArn' \
  --output text)
인덱스는 SDK로 생성합니다. dimension은 선택한 임베딩 모델의 출력 차원으로 맞춥니다. dataType은 벡터 요소의 자료형이고, distanceMetric은 코사인 유사도를 씁니다.
export VB_NAME="${VB_NAME}"
export INDEX_NAME="${INDEX_NAME}"
export EMB_DIM="${EMB_DIM}"
import boto3, os

s3v = boto3.client("s3vectors")
resp = s3v.create_index(
    vectorBucketName=os.environ["VB_NAME"],
    indexName=os.environ["INDEX_NAME"],
    dimension=int(os.environ["EMB_DIM"]),
    dataType="float32",
    distanceMetric="cosine"
)
print(resp["indexArn"])
dimension은 4절 변수 블록에서 선언한 EMB_DIM을 씁니다. 이 값은 임베딩 모델의 출력 차원과 정확히 같아야 하고, 어긋나면 4.4절 수집이 실패합니다. 다른 모델로 바꿀 때는 그 모델의 문서에서 차원을 확인해 EMB_MODEL과 EMB_DIM을 함께 고칩니다. 응답의 indexArn이 출력되면 인덱스가 만들어진 것입니다.
4.2 IAM 역할 만들기
Knowledge Bases가 S3 Vectors에 벡터를 쓰고 읽으려면 역할이 필요합니다. 또한 임베딩 모델을 호출할 권한도 이 역할에 담깁니다.
신뢰 정책을 먼저 만듭니다. Knowledge Bases 서비스가 이 역할을 빌려 쓸 수 있게 bedrock.amazonaws.com을 Principal로 지정합니다.
cat > kb-trust.json << EOF
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Principal": {
        "Service": "bedrock.amazonaws.com"
      },
      "Action": "sts:AssumeRole",
      "Condition": {
        "StringEquals": {
          "aws:SourceAccount": "${ACCOUNT}"
        }
      }
    }
  ]
}
EOF
aws:SourceAccount 조건을 걸어 다른 계정이 이 역할을 빌리는 것을 막습니다.
aws iam create-role \
  --role-name "${KB_ROLE_NAME}" \
  --assume-role-policy-document file://kb-trust.json

KB_ROLE_ARN="arn:aws:iam::${ACCOUNT}:role/${KB_ROLE_NAME}"
IAM 역할 ARN은 이름이 곧 경로이므로 조립해도 됩니다. 다음으로 권한 정책을 붙입니다. S3 Vectors 접근과 임베딩 모델 호출 권한을 하나의 인라인 정책에 담습니다.
cat > kb-permissions.json << EOF
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": [
        "s3vectors:*"
      ],
      "Resource": [
        "${VB_ARN}",
        "${VB_ARN}/*"
      ]
    },
    {
      "Effect": "Allow",
      "Action": [
        "bedrock:InvokeModel"
      ],
      "Resource": "arn:aws:bedrock:${REGION}::foundation-model/*"
    }
  ]
}
EOF
버킷 ARN과 그 하위를 모두 넣는 이유는 Knowledge Bases가 인덱스에 벡터를 쓰면서 버킷 자체를 대상으로 하는 조회도 보내기 때문입니다. 하위 경로만 넣으면 버킷 수준 호출이 거부됩니다. 액션을 s3vectors:*로 둔 것은 수집과 검색에서 쓰이는 액션 목록이 문서에 전부 나열되어 있지 않기 때문입니다. 운영 환경에서는 CloudTrail로 실제 호출된 액션을 확인해 좁힙니다.
aws iam put-role-policy \
  --role-name "${KB_ROLE_NAME}" \
  --policy-name "support-kb-permissions" \
  --policy-document file://kb-permissions.json
역할이 IAM에 전파되기까지 수 초가 걸립니다. 바로 다음 단계에서 역할을 쓰므로 잠시 기다립니다.
sleep 10
4.3 Knowledge Base 생성
Knowledge Base를 만들 때 필수 입력은 name, roleArn, knowledgeBaseConfiguration 세 가지입니다. 여기에 storageConfiguration을 함께 넘겨 S3 Vectors를 저장소로 지정합니다. storageConfiguration의 필수 멤버는 type 하나이고, 나머지는 type에 따라 달라집니다. s3VectorsConfiguration은 버킷 이름이 아니라 4.1절에서 받아 둔 vectorBucketArn을 받습니다. 인덱스는 indexName으로 가리키거나 indexArn을 직접 넘길 수도 있습니다.
cat > kb-storage.json << EOF
{
  "type": "S3_VECTORS",
  "s3VectorsConfiguration": {
    "vectorBucketArn": "${VB_ARN}",
    "indexName": "${INDEX_NAME}"
  }
}
EOF
임베딩 모델 ARN은 길어서 변수로 뺍니다.
EMB_ARN="arn:aws:bedrock:${REGION}::foundation-model"
EMB_ARN="${EMB_ARN}/${EMB_MODEL}"
cat > kb-config.json << EOF
{
  "type": "VECTOR",
  "vectorKnowledgeBaseConfiguration": {
    "embeddingModelArn": "${EMB_ARN}"
  }
}
EOF
KB_ID=$(aws bedrock-agent create-knowledge-base \
  --name "${KB_NAME}" \
  --role-arn "${KB_ROLE_ARN}" \
  --knowledge-base-configuration file://kb-config.json \
  --storage-configuration file://kb-storage.json \
  --query 'knowledgeBase.knowledgeBaseId' \
  --output text)
echo "KB_ID=${KB_ID}"
응답의 knowledgeBaseId는 영숫자 10자 이내의 문자열입니다. 이 값이 이후 모든 API 호출에서 Knowledge Base를 가리키는 식별자가 됩니다.
생성이 완료될 때까지 상태를 확인합니다.
for i in $(seq 1 60); do
  ST=$(aws bedrock-agent get-knowledge-base \
    --knowledge-base-id "${KB_ID}" \
    --query 'knowledgeBase.status' \
    --output text)
  [ "${ST}" = "ACTIVE" ] && break
  case "${ST}" in *FAILED*)
    echo "생성 실패: ${ST}"; exit 1 ;;
  esac
  echo "${i}/60 현재 상태 ${ST}"
  sleep 5
done
echo "최종 상태 ${ST}"
4.4 데이터 소스 연결과 수집
Knowledge Base가 만들어졌으면 환불 규정 문서가 들어 있는 S3 버킷을 데이터 소스로 연결합니다. <your-docs-bucket>은 환불·교환 규정 PDF나 텍스트 파일이 올라가 있는 일반 S3 버킷 이름입니다. 이미 있는 버킷을 쓰거나, 없다면 아래 명령으로 먼저 만듭니다.
DOCS_BUCKET=<your-docs-bucket>
aws s3 mb "s3://${DOCS_BUCKET}" \
  --region "${REGION}"
버킷을 만들었으면 환불 규정 파일을 올립니다. 파일이 이미 올라가 있다면 이 단계는 건너뜁니다.
aws s3 cp ./refund-policy.pdf \
  "s3://${DOCS_BUCKET}/"
문서를 올리지 않은 채 수집을 돌리면 벡터가 하나도 만들어지지 않습니다. 그 상태에서 5절 Retrieve를 호출하면 빈 배열이 돌아옵니다.
cat > ds-config.json << EOF
{
  "type": "S3",
  "s3Configuration": {
    "bucketArn": "arn:aws:s3:::${DOCS_BUCKET}"
  }
}
EOF
DS_ID=$(aws bedrock-agent create-data-source \
  --knowledge-base-id "${KB_ID}" \
  --name "support-refund-docs" \
  --data-source-configuration file://ds-config.json \
  --query 'dataSource.dataSourceId' \
  --output text)
echo "DS_ID=${DS_ID}"
데이터 소스를 만들었으면 수집(Ingestion)을 시작합니다. 수집은 문서를 청크로 쪼개고 임베딩 벡터로 변환해 S3 Vectors 인덱스에 넣는 작업입니다.
JOB_ID=$(aws bedrock-agent start-ingestion-job \
  --knowledge-base-id "${KB_ID}" \
  --data-source-id "${DS_ID}" \
  --query 'ingestionJob.ingestionJobId' \
  --output text)
echo "JOB_ID=${JOB_ID}"
수집 완료까지 문서 양에 따라 수십 초에서 수 분이 걸립니다. 상태를 확인합니다.
for i in $(seq 1 120); do
  JOB_ST=$(aws bedrock-agent get-ingestion-job \
    --knowledge-base-id "${KB_ID}" \
    --data-source-id "${DS_ID}" \
    --ingestion-job-id "${JOB_ID}" \
    --query 'ingestionJob.status' \
    --output text)
  [ "${JOB_ST}" = "COMPLETE" ] && break
  case "${JOB_ST}" in *FAILED*)
    echo "수집 실패: ${JOB_ST}"; exit 1 ;;
  esac
  echo "${i}/120 수집 상태 ${JOB_ST}"
  sleep 5
done
echo "수집 최종 상태 ${JOB_ST}"
4.5 에이전트가 Knowledge Base를 검색하게 하기
2편에서 배포한 상담 에이전트가 이 Knowledge Base를 쓰게 만듭니다. 먼저 짚어 둘 것이 하나 있습니다. 이 작업을 검색하면 AssociateAgentKnowledgeBase API가 먼저 나오는데, 그 API는 Bedrock Agents 전용입니다. 2편에서 배포한 것은 AgentCore Runtime 에이전트이므로 이 API의 대상이 아닙니다. AgentCore Gateway의 Knowledge Base 커넥터도 managed Knowledge Base만 받으므로, 이 글에서 만든 customer-managed Knowledge Base에는 붙지 않습니다.
그러면 AgentCore Runtime 에이전트는 Knowledge Base를 어떻게 쓸까요? Retrieve를 직접 호출합니다. 할 일은 둘입니다. 실행 역할에 Retrieve 권한을 주고, 에이전트 코드가 Retrieve를 부르게 한 뒤 다시 배포합니다.
먼저 2편에서 만든 실행 역할에 권한을 붙입니다. Resource를 방금 만든 Knowledge Base ARN으로 좁히면 다른 Knowledge Base로는 질의가 나가지 않습니다.
KB_ARN="arn:aws:bedrock:${REGION}:${ACCOUNT}"
KB_ARN="${KB_ARN}:knowledge-base/${KB_ID}"

cat > agent-kb-policy.json << EOF
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": "bedrock:Retrieve",
      "Resource": "${KB_ARN}"
    }
  ]
}
EOF
aws iam put-role-policy \
  --role-name "${AGENT_ROLE_NAME}" \
  --policy-name "support-agent-kb-retrieve" \
  --policy-document file://agent-kb-policy.json
다음으로 에이전트 코드가 Retrieve를 부르게 합니다. 2편 4.2절의 main.py에 아래 함수를 더합니다. Knowledge Base ID는 코드에 박지 않고 환경 변수로 받습니다. 컨테이너에는 뒤에서 update-agent-runtime의 --environment-variables로 넘깁니다. 이미지를 만들기 전에 이 함수만 먼저 돌려 보려면 셸에서 내보내 둡니다.
export KB_ID="${KB_ID}"
# app/main.py 에 더한다
import boto3, os

_kb = boto3.client("bedrock-agent-runtime")
KB_ID = os.environ["KB_ID"]


def search_policy(question):
    """규정 문서에서 질문과 관련된 청크를 꺼낸다."""
    resp = _kb.retrieve(
        knowledgeBaseId=KB_ID,
        retrievalQuery={"text": question}
    )
    out = []
    for r in resp.get("retrievalResults", []):
        out.append({
            "text": r["content"]["text"],
            "score": r.get("score"),
            "source": r.get("location", {})
        })
    return out
/invocations 핸들러가 이 함수를 불러 결과를 모델 프롬프트의 근거로 넣고, source를 답변에 출처로 붙입니다.
코드를 고쳤으니 이미지를 다시 만들어 올립니다. ECR_REPO는 2편에서 만든 리포지터리 이름입니다. 2편은 태그를 latest로 두었지만 같은 태그를 다시 밀면 지금 떠 있는 것이 어느 이미지인지 구분되지 않으므로, 새 태그를 붙입니다.
ECR_REPO=support-agent
IMAGE_TAG=kb-retrieve
ECR_URI="${ACCOUNT}.dkr.ecr.${REGION}.amazonaws.com"
CONTAINER_URI="${ECR_URI}/${ECR_REPO}:${IMAGE_TAG}"

aws ecr get-login-password --region "${REGION}" \
  | docker login --username AWS \
    --password-stdin "${ECR_URI}"

docker build --platform linux/arm64 \
  -t "${ECR_REPO}:${IMAGE_TAG}" .
docker tag "${ECR_REPO}:${IMAGE_TAG}" "${CONTAINER_URI}"
docker push "${CONTAINER_URI}"
그다음 Runtime이 새 이미지와 KB_ID를 쓰도록 갱신합니다.
AGENT_ROLE_ARN="arn:aws:iam::${ACCOUNT}:role"
AGENT_ROLE_ARN="${AGENT_ROLE_ARN}/${AGENT_ROLE_NAME}"

cat > rt-artifact.json << EOF
{
  "containerConfiguration": {
    "containerUri": "${CONTAINER_URI}"
  }
}
EOF

cat > rt-network.json << EOF
{
  "networkMode": "PUBLIC"
}
EOF

cat > rt-env.json << EOF
{
  "KB_ID": "${KB_ID}"
}
EOF
UpdateAgentRuntime의 필수 입력은 agentRuntimeId, agentRuntimeArtifact, roleArn 셋입니다. --network-configuration은 필수가 아니지만 함께 넘깁니다. 생략하면 2편에서 지정한 PUBLIC 모드가 유지되지 않을 수 있습니다.
aws bedrock-agentcore-control update-agent-runtime \
  --agent-runtime-id "${RUNTIME_ID}" \
  --role-arn "${AGENT_ROLE_ARN}" \
  --agent-runtime-artifact file://rt-artifact.json \
  --network-configuration file://rt-network.json \
  --environment-variables file://rt-env.json
갱신이 반영될 때까지 상태를 확인합니다.
for i in $(seq 1 60); do
  ST=$(aws bedrock-agentcore-control get-agent-runtime \
    --agent-runtime-id "${RUNTIME_ID}" \
    --query 'status' --output text)
  [ "${ST}" = "READY" ] && break
  case "${ST}" in *FAILED*)
    echo "갱신 실패: ${ST}"; exit 1 ;;
  esac
  echo "${i}/60 현재 상태 ${ST}"
  sleep 5
done
echo "최종 상태 ${ST}"
상태가 READY로 돌아오면 에이전트가 환불 규정 질문에 Knowledge Base의 청크를 근거로 쓸 수 있는 상태가 됩니다.
5. 동작 확인 — 환불 규정 문서를 근거로 답변 받기
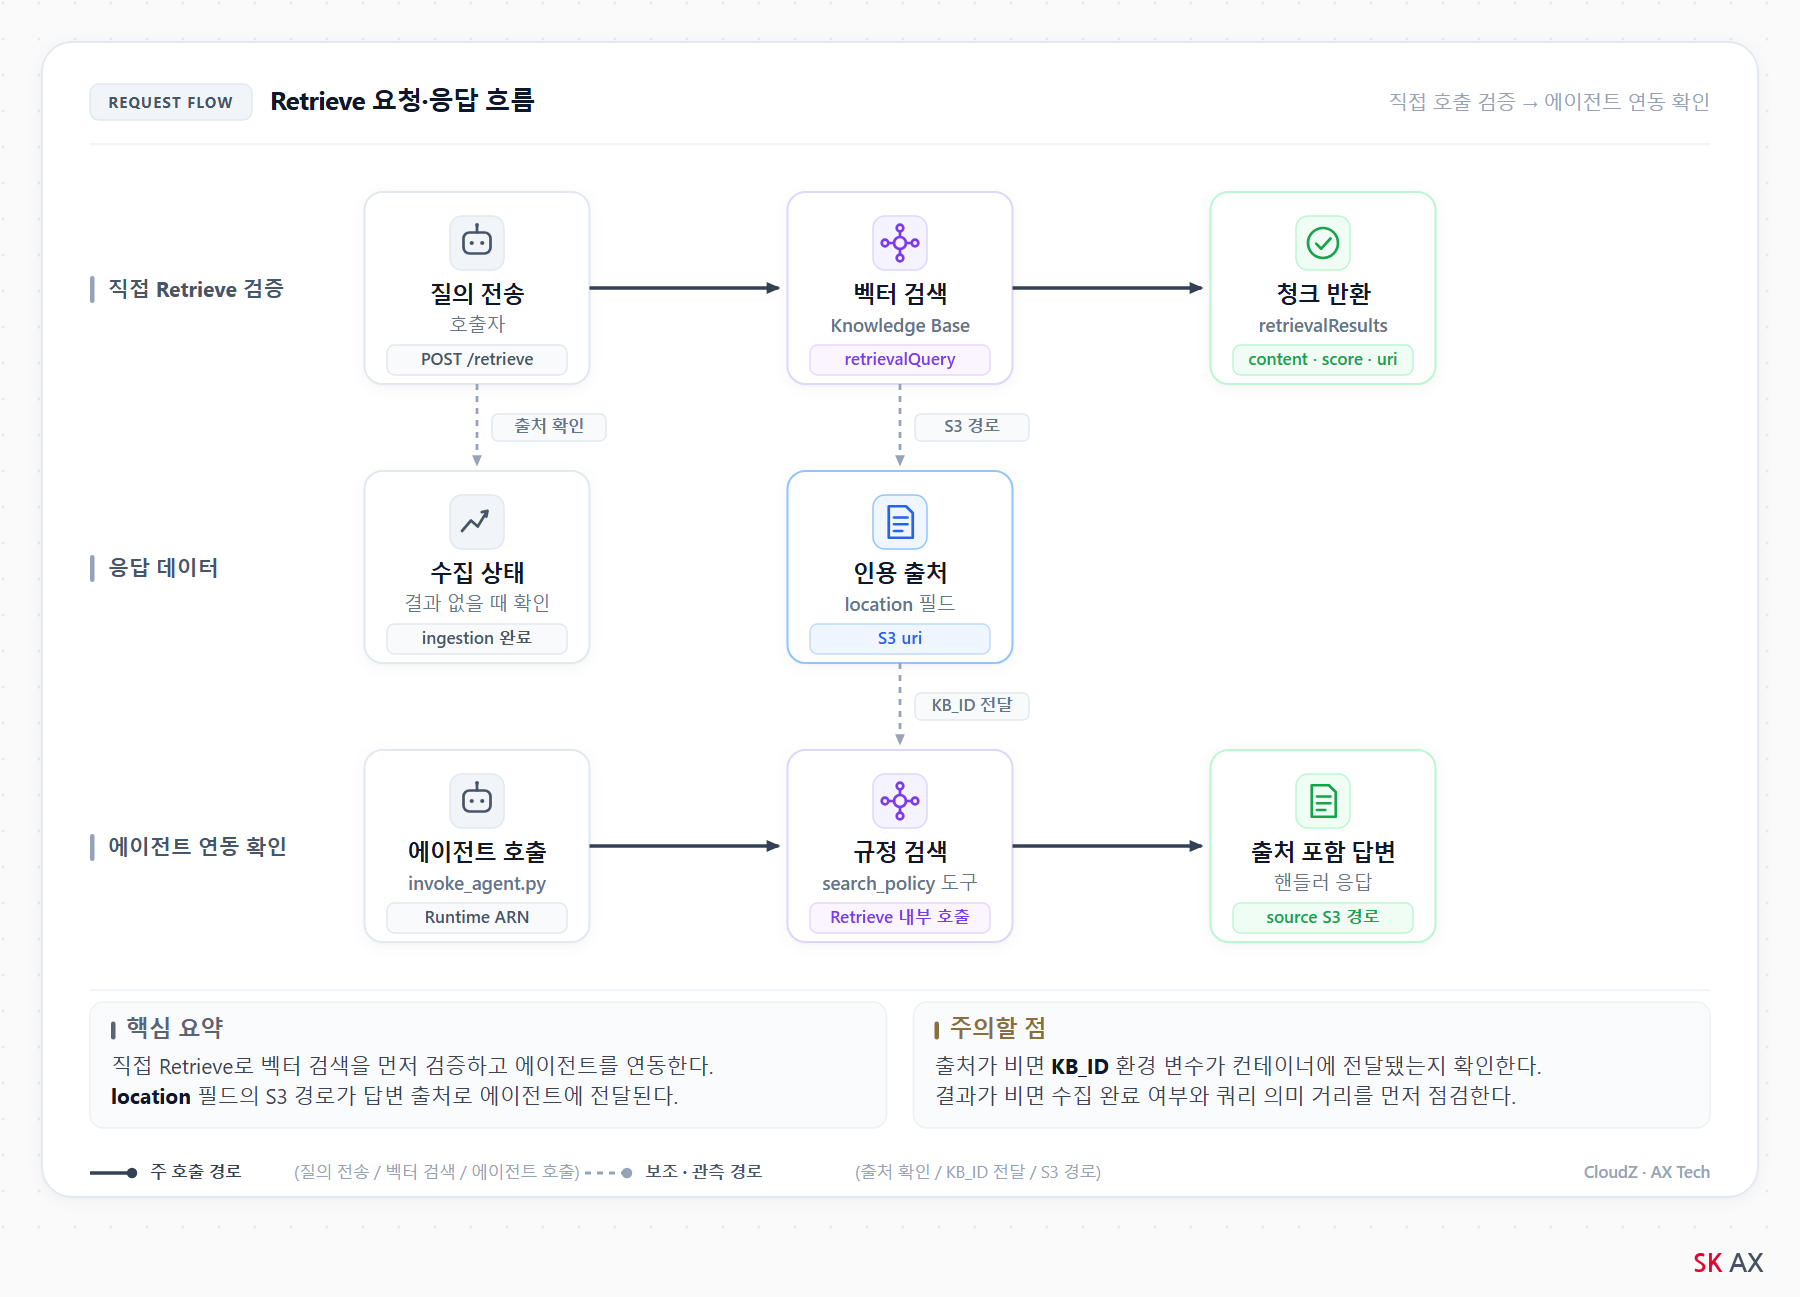
[그림 4] Retrieve 요청·응답 흐름 — 에이전트 질의에서 청크 반환과 인용 출처 포함까지
에이전트를 거치지 않고 Knowledge Base에 직접 Retrieve를 호출해 벡터 검색이 제대로 되는지 먼저 확인합니다. 이렇게 하면 에이전트 오케스트레이션 문제와 Knowledge Base 문제를 분리해서 볼 수 있습니다.
aws bedrock-agent-runtime retrieve \
  --knowledge-base-id "${KB_ID}" \
  --retrieval-query \
    '{"text": "셔츠 구매 후 열흘 지났는데 환불 가능한가요?"}'
응답은 retrievalResults 배열에 관련 청크를 담아 돌려줍니다. 각 요소에는 청크 텍스트와 점수, 그리고 출처 정보가 들어 있습니다. 아래 예시의 uri 값은 4.4절에서 문서를 올린 버킷 경로이고, 여러분 환경에서는 DOCS_BUCKET에 넣은 이름으로 돌아옵니다.
{
  "retrievalResults": [
    {
      "content": {
        "text": "의류 제품은 구매일로부터 14일 이내..."
      },
      "score": 0.82,
      "location": {
        "type": "S3",
        "s3Location": {
          "uri": "s3://support-refund-docs/refund-policy.pdf"
        }
      }
    }
  ]
}
결과가 돌아왔다면 벡터 검색이 정상 동작하는 것입니다. location 필드에 원본 문서의 S3 경로가 담겨 있으므로, 에이전트가 이 정보를 답변에 인용 출처로 붙일 수 있습니다. 결과가 비어 있다면 수집이 아직 끝나지 않았거나 쿼리와 문서 사이의 의미 거리가 먼 것이므로, 수집 상태를 먼저 확인해야 합니다.
이제 에이전트를 통해 같은 질문을 던져 봅니다. 2편 4.4절에서 만든 invoke_agent.py를 그대로 쓰고 질문만 바꿉니다. 호출에 필요한 Runtime ARN을 먼저 꺼냅니다.
RUNTIME_ARN=$(aws bedrock-agentcore-control \
  get-agent-runtime \
  --agent-runtime-id "${RUNTIME_ID}" \
  --query 'agentRuntimeArn' --output text)

export RUNTIME_ARN="${RUNTIME_ARN}"
export REGION="${REGION}"
import boto3, json, os, uuid

client = boto3.client(
    "bedrock-agentcore",
    region_name=os.environ["REGION"]
)
session_id = "sess-" + uuid.uuid4().hex

resp = client.invoke_agent_runtime(
    agentRuntimeArn=os.environ["RUNTIME_ARN"],
    runtimeSessionId=session_id,
    payload=json.dumps({
        "query": "이 셔츠 환불되나요? 산 지 열흘 됐는데요."
    }).encode("utf-8")
)
print(resp["response"].read().decode("utf-8"))
4.5절에서 더한 search_policy가 돌려준 source를 핸들러가 답변에 붙였다면, 출력에 규정 문서의 S3 경로가 함께 찍힙니다. 에이전트가 주문 조회 도구 대신 규정 검색을 택하고 답변에 출처가 딸려 오면 연동이 된 것입니다. 출처가 비어 있다면 핸들러가 search_policy를 부르지 않았거나 KB_ID가 컨테이너에 전달되지 않은 것이므로, get-agent-runtime 응답의 environmentVariables를 먼저 확인합니다.
6. 성능과 비용 — 저장소별 지연·쿼터·요금 비교
쿼리 지연
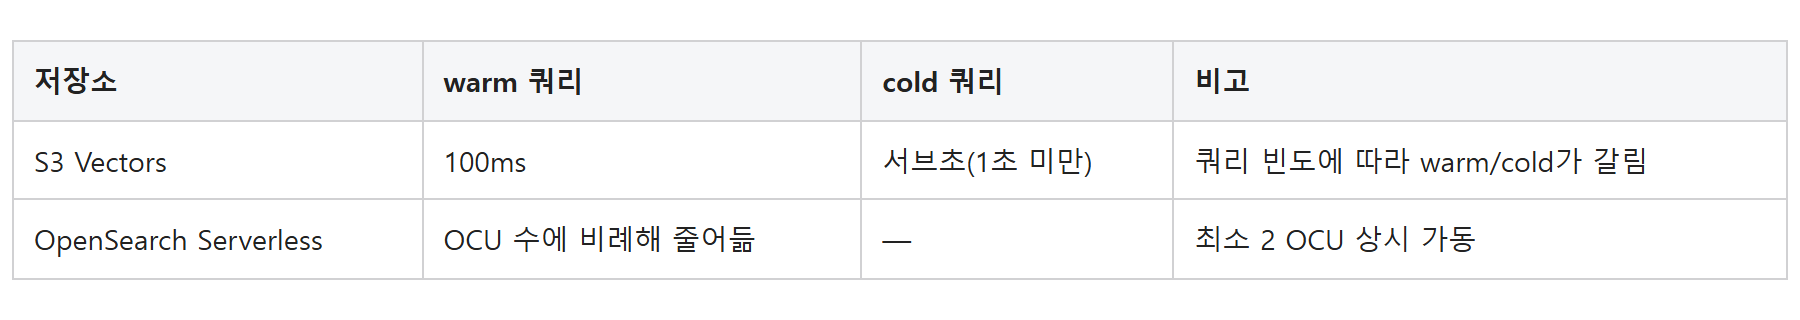
S3 Vectors에서 warm과 cold는 쿼리 빈도와 접근 패턴에 따른 구분입니다. 자주 조회되는 인덱스는 warm 경로를 타고 100ms 수준으로 응답하지만, 한동안 조회가 없던 인덱스는 cold 경로를 타서 서브초까지 느려집니다. Retrieve 버스트 상한이 초당 25건이므로, warm 쿼리 100ms 기준으로 동시에 비행 중인 쿼리는 3건 이하입니다. 버스트 구간에서도 warm 경로는 감당할 수 있지만, cold 쿼리가 섞이면 동시성이 급증해 지연이 튈 수 있습니다.
Retrieve 쿼터
지식 베이스당 최대 Retrieve 요청 수는 분당 600건(RPM)이며, 초당 25건의 버스트를 지원합니다. 이 쿼터는 조정 가능합니다.
Retrieve 요금
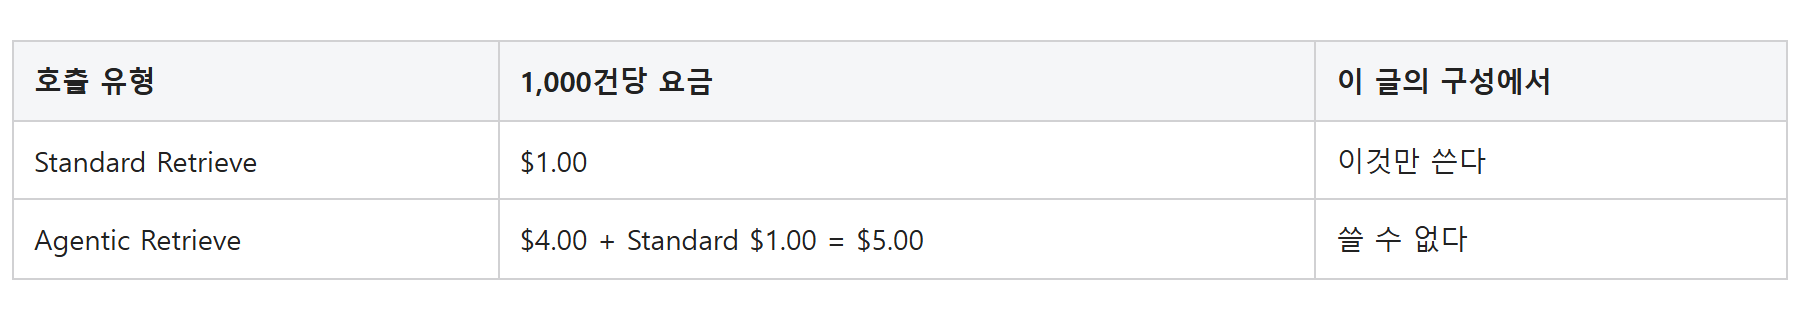
Agentic Retrieve는 에이전트가 질의를 스스로 계획해 여러 번 검색하는 모드입니다. 호출 건당 $4.00에 더해 내부적으로 발생하는 Standard Retrieve 호출료 $1.00이 별도로 붙어, 같은 건수에서 Standard의 5배가 됩니다. 다만 3절에서 적은 대로 이 모드는 managed Knowledge Base 전용입니다. 저장소를 직접 고른 이 글의 구성에서는 선택지가 아니고, 저장소 선택권의 대가가 여기서 숫자로 드러납니다.
그래서 이 구성의 Retrieve 비용은 호출 횟수에 정비례합니다.
월 호출 수 = 일 호출 수 × 30
월 비용    = 월 호출 수 ÷ 1000 × 1.00

일 100건   → 월 3,000건  → $3.00
일 1,000건 → 월 30,000건 → $30.00
요금을 줄이는 지점은 에이전트 코드입니다. 한 문의에 Retrieve를 두세 번 부르면 요금도 쿼터도 그만큼 빨리 당겨집니다.
OpenSearch Serverless 최소 과금
OpenSearch Serverless Classic 컬렉션은 계정 첫 번째 컬렉션에 대해 인덱싱 1 OCU, 검색 1 OCU로 최소 2 OCU가 과금됩니다. 컬렉션 그룹의 최솟값을 1 OCU로 낮출 수는 있지만, 인덱싱과 검색에 각 1 OCU가 바닥이므로 2 OCU 아래로는 내려갈 수 없습니다. OCU는 시간 단위(초 단위 세분화)로 과금되므로, 트래픽이 없는 시간에도 비용이 발생합니다. 실제 최소 OCU는 데이터 크기와 컬렉션 유형에 따라 달라질 수 있습니다.
7. 운영 시 주의사항
Retrieve RPM 쿼터를 모니터링합니다. 지식 베이스당 분당 600건이 기본 쿼터이고 초당 25건 버스트를 지원합니다. 상담 에이전트가 한 문의에 Retrieve를 두세 번 호출하는 구조라면 분당 600건 쿼터에 빠르게 닿습니다. 쿼터를 넘으면 ThrottlingException이 돌아오고 에이전트가 답변을 못 합니다. 쿼터는 조정 가능하므로 트래픽이 늘기 전에 한도 증설을 요청합니다.
쿼터 상한까지 사용하면 월 최대 호출 수는 25,920,000건이고, Standard Retrieve 기준 월 비용은 $25,920입니다. 이 수준의 트래픽이라면 비용 상한 알림을 먼저 설정해야 합니다.
S3 Vectors의 cold 쿼리 지연에 대비합니다. 야간이나 주말처럼 트래픽이 끊기는 시간대 뒤에 첫 쿼리가 들어오면 cold 경로를 타서 서브초까지 느려집니다. warm 쿼리의 100ms와 체감 차이가 큽니다. 특히 업무 시작 전에 워밍 쿼리를 한 건 보내 두면 첫 고객의 대기 시간을 줄이는 데 도움이 됩니다.
에이전트가 Retrieve를 언제 부를지 좁힙니다. AgentCore Runtime 에이전트는 Retrieve를 직접 호출하므로, 호출 여부를 정하는 것은 에이전트 코드와 모델 프롬프트입니다. 모든 문의에서 search_policy를 부르면 배송 문의나 단순 인사에도 Retrieve 비용이 나갑니다. 환불·교환·반품처럼 규정이 필요한 질문에서만 부르도록 프롬프트에 조건을 적고, 주문 상태 조회는 3편에서 연결한 Gateway 도구로 보냅니다.
Agentic retrieval이 필요해지면 저장소 선택을 다시 봅니다. Agentic Retrieve는 managed Knowledge Base 전용이므로 저장소를 직접 고른 이 구성에서는 켤 수 없습니다. 에이전트가 질의를 스스로 계획해 여러 지식 베이스를 넘나들어야 한다면 Knowledge Base를 managed로 다시 만들어야 하고, 그때는 S3 Vectors를 비롯한 저장소 선택권을 내놓게 됩니다. 요금은 같은 건수에서 Standard의 5배입니다. 저장소를 고르는 시점에 이 갈림을 함께 정하는 편이 나중에 다시 만드는 것보다 쌉니다.
bedrock:RetrieveAndGenerate 권한의 Resource는 와일드카드(*)로 지정합니다. bedrock:Retrieve는 Knowledge Base ARN을 특정할 수 있지만, RetrieveAndGenerate는 와일드카드만 받습니다. 두 Action을 한 정책에 넣을 때 Resource를 같은 ARN으로 묶으면 RetrieveAndGenerate 호출이 거부됩니다. 따라서 Statement를 나눠서 각각의 Resource를 맞춰야 합니다.
8. 리소스 정리
삭제는 의존성 역순입니다. 데이터 소스를 먼저 지운 뒤 Knowledge Base를 지우고, S3 Vectors 버킷을 지우려면 안의 인덱스를 먼저 지워야 합니다. 에이전트 실행 역할에 붙인 Retrieve 권한도 함께 떼어 냅니다.
aws iam delete-role-policy \
  --role-name "${AGENT_ROLE_NAME}" \
  --policy-name "support-agent-kb-retrieve"

aws bedrock-agent delete-data-source \
  --knowledge-base-id "${KB_ID}" \
  --data-source-id "${DS_ID}"

aws bedrock-agent delete-knowledge-base \
  --knowledge-base-id "${KB_ID}"
S3 Vectors 인덱스와 버킷은 SDK로 삭제합니다.
export VB_NAME="${VB_NAME}"
export INDEX_NAME="${INDEX_NAME}"
import boto3, os

s3v = boto3.client("s3vectors")
s3v.delete_index(
    vectorBucketName=os.environ["VB_NAME"],
    indexName=os.environ["INDEX_NAME"]
)
s3v.delete_vector_bucket(
    vectorBucketName=os.environ["VB_NAME"]
)
print("S3 Vectors 정리 완료")
4.4절에서 만든 문서 버킷도 지웁니다. 버킷 안의 파일까지 함께 삭제됩니다.
aws s3 rb "s3://${DOCS_BUCKET}" --force
마지막으로 IAM 역할을 지웁니다. 인라인 정책을 먼저 제거해야 역할이 삭제됩니다.
aws iam delete-role-policy \
  --role-name "${KB_ROLE_NAME}" \
  --policy-name "support-kb-permissions"

aws iam delete-role \
  --role-name "${KB_ROLE_NAME}"
맺음말
이번 편에서 에이전트가 환불·교환 규정 문서를 근거로 답변하는 구조를 만들었습니다. 서론에서 세운 문제 — 규정이 바뀔 때마다 에이전트를 재배포해야 하는 것 — 는 Knowledge Bases가 문서 수집과 에이전트 코드를 분리해 줌으로써 풀렸습니다. 문서가 바뀌면 수집만 다시 돌리면 됩니다.
벡터 저장소 선택은 트래픽 패턴에 달려 있습니다. 상담 에이전트처럼 트래픽이 업무 시간에 몰리고 야간에 끊기는 패턴이라면 S3 Vectors가 답입니다. 쿼리 건수 비례 과금이라 야간 비용이 거의 없고, 별도 클러스터를 관리할 일도 없습니다. 반면 전문 검색과 벡터 검색을 함께 써야 하고 최소 2 OCU 상시 과금이 부담이 되지 않는 규모라면 OpenSearch Serverless를 검토합니다.
비용에서 가장 주의할 지점은 저장소의 바닥 비용입니다. Retrieve는 1,000건당 $1.00으로 호출 횟수에 정비례하지만, 저장소 쪽은 트래픽이 없어도 나가는 몫이 있습니다. OpenSearch Serverless Classic의 최소 2 OCU가 그것이고, S3 Vectors에는 그 몫이 없습니다.
다음 10편에서는 고액 환불 요청처럼 사람의 판단이 필요한 경우에 Step Functions로 승인 단계를 넣는 방법을 다룹니다.
참고 자료
- Amazon Bedrock Knowledge Bases StorageConfiguration API 레퍼런스 — 지원되는 벡터 저장소 type 유효값 8종을 확인할 수 있습니다.
- Amazon Bedrock Knowledge Bases 권한 설정 —
bedrock:Retrieve와bedrock:RetrieveAndGenerate의 Resource ARN 형식 차이가 정리되어 있습니다. - Amazon Bedrock Knowledge Bases 관리형 쿼터 — Retrieve RPM 기본 쿼터와 조정 가능 여부를 다룹니다.
- Amazon Bedrock 요금 — Standard Retrieve와 Agentic Retrieve의 건당 요금이 나와 있습니다.
- Amazon S3 Vectors 모범 사례 — warm/cold 쿼리 지연과 성능 최적화 방법을 안내합니다.
- Amazon S3 Vectors 기능 소개 — 인덱스당 최대 벡터 수 등 용량 사양이 정리되어 있습니다.
- Amazon OpenSearch Serverless 요금 — Classic 컬렉션 최소 OCU 과금 구조를 다룹니다.
- Bedrock Managed와 Customer-managed Knowledge Base 비교 — Agentic retrieval과 AgentCore Gateway 연동이 managed 전용인 이유가 표로 정리되어 있습니다.
- Amazon Bedrock DeleteKnowledgeBase API 레퍼런스 — 삭제 전 연결 해제 요구사항을 안내합니다.
- S3 Vectors 버킷 삭제 — 인덱스를 먼저 삭제해야 하는 의존성이 설명되어 있습니다.