
Evaluations 내장·커스텀 평가자 선택 기준과 운영 회고 방법
막는 것과 잘하는 것은 다른 문제입니다. "어제 주문한 셔츠가 아직 안 왔어요"라는 문의에 에이전트가 배송 상태를 정확히 안내했는지, 아니면 맞는 말 같지만 핵심을 빗나간 답을 줬는지는 11편에서 고른 Guardrails가 가리지 못하는 영역입니다.
지금까지 열한 편에 걸쳐 에이전트를 올리고, 도구를 붙이고, 기억을 주고, 권한을 좁히고, 비용을 재고, 상태를 들여다보고, 위험을 막았습니다. 그러나 이 모든 것이 제대로 맞물려 돌아가는지 확인하는 장치가 아직 없습니다. 사람이 답변을 하나씩 읽어 보는 것은 문의가 하루 수백 건을 넘어가면 불가능해집니다.
Amazon Bedrock Evaluations와 AgentCore Evaluations는 이 빈자리를 채웁니다. 에이전트 답변에 점수를 매기고, 그 점수가 떨어지면 어디를 고쳐야 하는지 추적할 수 있는 구조를 제공합니다.
Evaluations 콘솔 UI의 상세 조작법, LLM-as-judge 모델 자체의 파인튜닝, A/B 테스트 프레임워크 구축은 다루지 않습니다. CloudWatch 대시보드 구성은 7편에서 다뤘고, Guardrails와 Policy의 선택 기준은 11편에서 다뤘습니다.
3줄 요약
- 내장 평가자는 입력 토큰 1M당 $2.40, 출력 토큰 1M당 $12.00이 들고, 커스텀 평가자는 1,000건당 $1.50에 모델 비용이 따로 붙습니다. 답변이 길면 내장 쪽이 비싸집니다.
- AgentCore Evaluations는 에이전트의 OpenTelemetry trace를 채점합니다. 7편 계측이 그대로 입력이 되고, 배포 전엔 온디맨드로 프로덕션엔 온라인으로 돌리는 것이 권장 패턴입니다.
- 자동 점수만으로는 "고객이 실제로 만족했는가"를 알 수 없습니다. 사람이 에이전트 답변을 고쳐 보낸 비율을 함께 추적하면 자동 점수가 놓치는 품질 저하를 잡아낼 수 있습니다.
검증 환경
1. 왜 점수가 필요한가 — 직관이 틀리는 지점
2편에서 올린 쇼핑몰 상담 에이전트가 한 달째 돌고 있다고 해 보겠습니다. 하루 수백 건 문의를 처리하고, 팀장이 매일 아침 답변 열 건쯤 골라 읽습니다. 열 건이 괜찮으면 "오늘도 잘 돌고 있다"고 판단합니다.
그런데 이 판단에는 두 가지 구멍이 있습니다.
하나는 표본이 편향된다는 것입니다. 사람은 짧고 깔끔한 답변을 먼저 고르는 경향이 있습니다. 배송 지연 문의처럼 상황이 복잡하고 답변이 긴 건은 나중에 보려다 넘어갑니다. 정작 품질이 갈리는 것은 그 복잡한 건인데, 표본에서 빠집니다.
다른 하나는 변화를 감지하지 못한다는 것입니다. 9편에서 연결한 Knowledge Bases의 환불 규정 문서가 지난주에 바뀌었는데, 에이전트가 옛 규정으로 답하고 있다면 어떨까요. 열 건 중에 환불 문의가 한 건도 없으면 팀장은 알아차리지 못합니다. 일주일 뒤 고객 불만이 쌓여서야 문제가 드러납니다.
점수는 이 두 구멍을 메웁니다. 모든 답변에 자동으로 점수를 매기면 표본 편향이 사라지고, 점수 추이를 보면 어제와 오늘의 차이가 숫자로 드러납니다. 감각으로 "괜찮다"고 느끼는 것과 점수가 0.82에서 0.71로 떨어진 것을 보는 것은 전혀 다른 판단 근거를 줍니다.
2. Evaluations 구조 — trace와 평가자, 실행 모드의 관계
이름이 비슷한 서비스가 둘입니다. 먼저 가르고 들어갑니다.
Amazon Bedrock Evaluations는 모델과 RAG 파이프라인을 평가합니다. 데이터셋을 주면 Bedrock이 지정한 모델을 직접 호출해 답변을 만들고 채점합니다. 평가 대상이 모델입니다.
AgentCore Evaluations는 에이전트가 남긴 실행 기록을 평가합니다. Strands나 LangGraph로 만든 에이전트의 OpenTelemetry trace를 받아 통일된 형식으로 바꾼 뒤 LLM-as-judge로 채점합니다. 평가 대상이 에이전트입니다.
이 연재가 쓸 것은 후자입니다. 2편에서 Strands로 에이전트를 만들고 7편에서 Observability를 깔았으니 trace가 이미 나가고 있습니다. 그것이 곧 평가 입력입니다. 같은 에이전트를 Bedrock Evaluations의 데이터셋 경로로 보내면 모델만 채점되고, 3편에서 붙인 도구나 9편의 Knowledge Bases는 점수에 들어가지 않습니다. 이미 만들어 둔 응답을 그쪽으로 채점하려면 모델을 지정하는 대신 precomputedInferenceSource로 응답을 직접 넣어야 합니다.
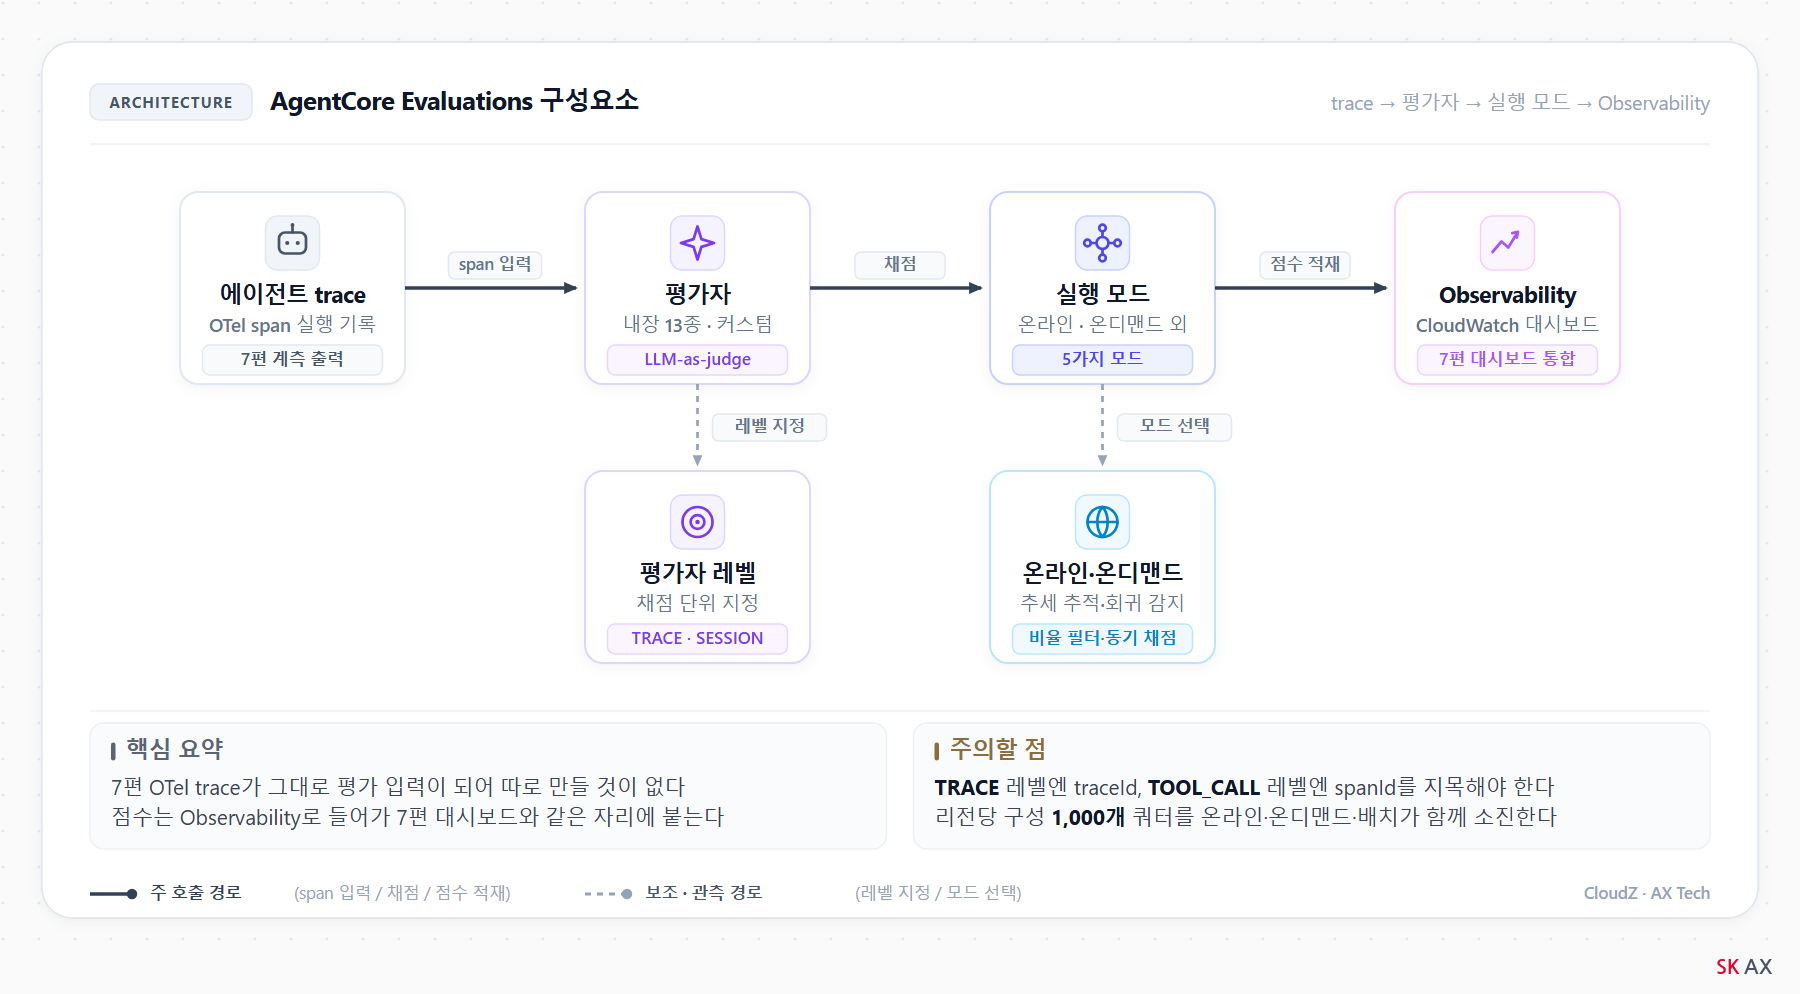
[그림 1] AgentCore Evaluations 구성요소 — 에이전트 trace와 평가자, 실행 모드, 결과 적재의 관계
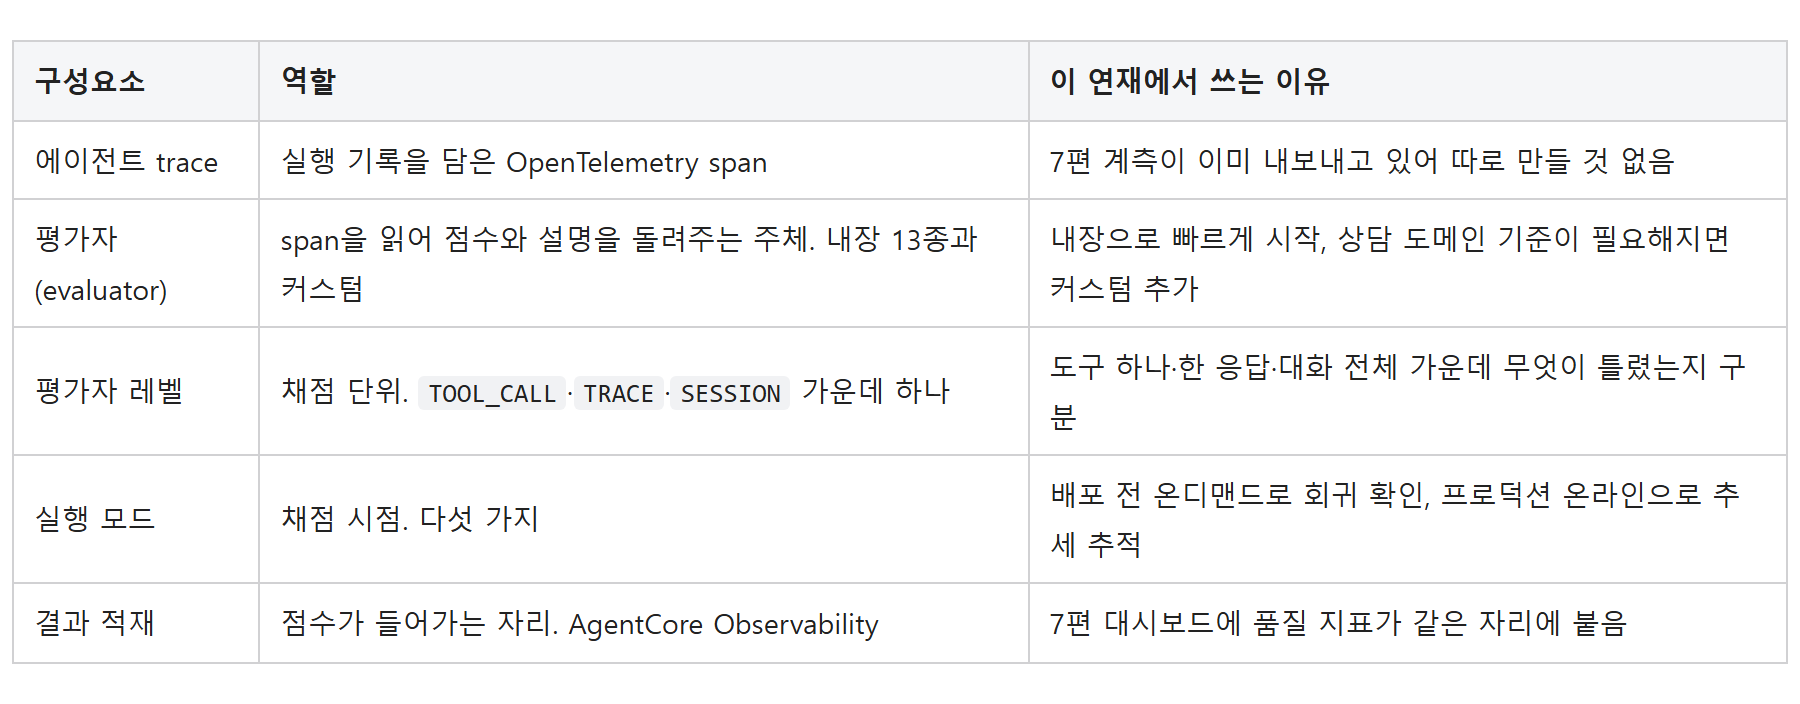
흐름은 이렇습니다. 에이전트가 문의를 처리하면서 span을 내보내고, 평가자가 그 span을 읽어 점수와 설명을 돌려주고, 점수가 Observability로 들어갑니다. 내장 평가자와 커스텀 평가자는 같은 실행 모드 안에서 골라 쓰므로, 처음에 내장으로 시작했다가 도메인 기준이 필요해지면 커스텀을 더하는 것이 자연스럽습니다.
에이전트 trace가 입력입니다. 7편에서 깔아 둔 계측이 문의 한 건을 세션으로 묶고, 그 안에 모델 호출과 도구 호출을 span으로 남깁니다. 평가자는 이 span을 읽습니다. 따로 질문·기대 답변 쌍을 만들어 두지 않아도 프로덕션 트래픽이 그대로 평가 대상이 됩니다. 기대 답변을 쥐고 비교해야 하는 경우에는 온디맨드 호출에 기대 응답이나 기대 도구 순서를 함께 넘길 수 있습니다.
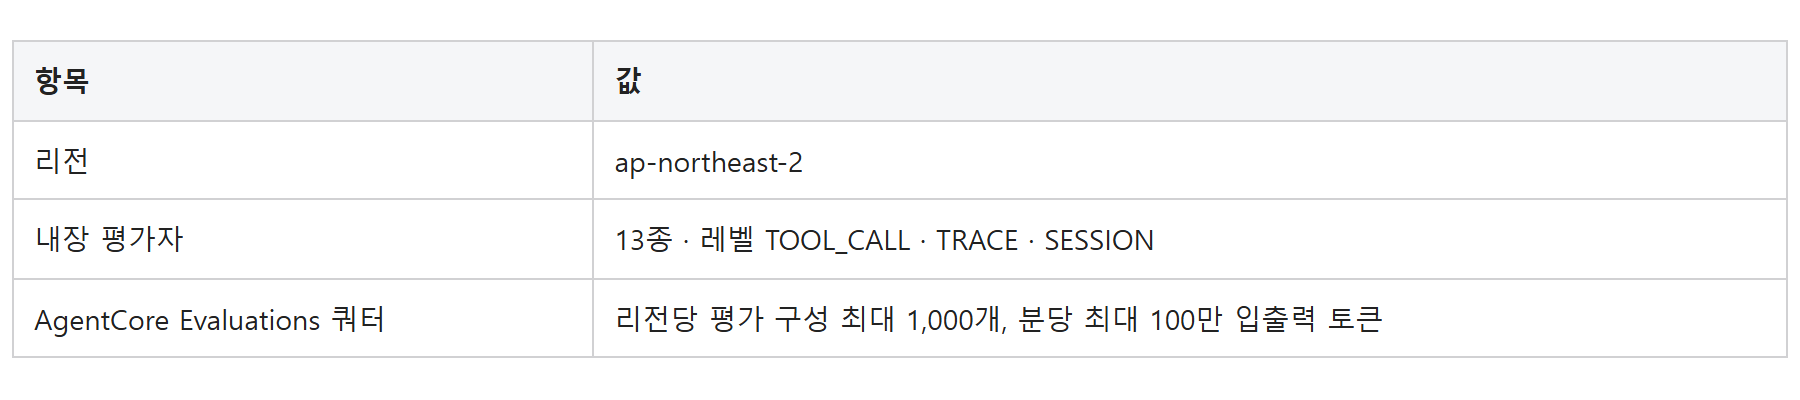
평가자(evaluator)는 LLM-as-judge 방식으로 동작합니다. 사람 대신 LLM이 채점관을 맡는 구조인데, 점수만 주는 것이 아니라 왜 그 점수를 줬는지 설명까지 돌려줍니다. 내장 평가자는 13종이고 ARN이 arn:aws:bedrock-agentcore:::evaluator/Builtin.Helpfulness 꼴로 계정 없이 공용입니다. 커스텀 평가자는 여러분 계정에 만들어지고 ARN에 리전과 계정이 들어갑니다.
평가자마다 레벨이 정해져 있습니다. Builtin.Helpfulness나 Builtin.Correctness는 응답 하나를 보는 TRACE 레벨이고, Builtin.ToolSelectionAccuracy는 도구 호출 하나를 보는 TOOL_CALL 레벨입니다. 레벨이 다르면 평가를 걸 때 지목하는 식별자도 달라집니다. 5절에서 점수 하락 원인을 프롬프트·도구·Memory로 가르는데, 그 분류가 이 레벨과 그대로 짝을 이룹니다. 비용과 적용 조건 비교는 3절에서 이어집니다.
실행 모드가 언제 채점할지를 정합니다. 다섯 가지입니다.
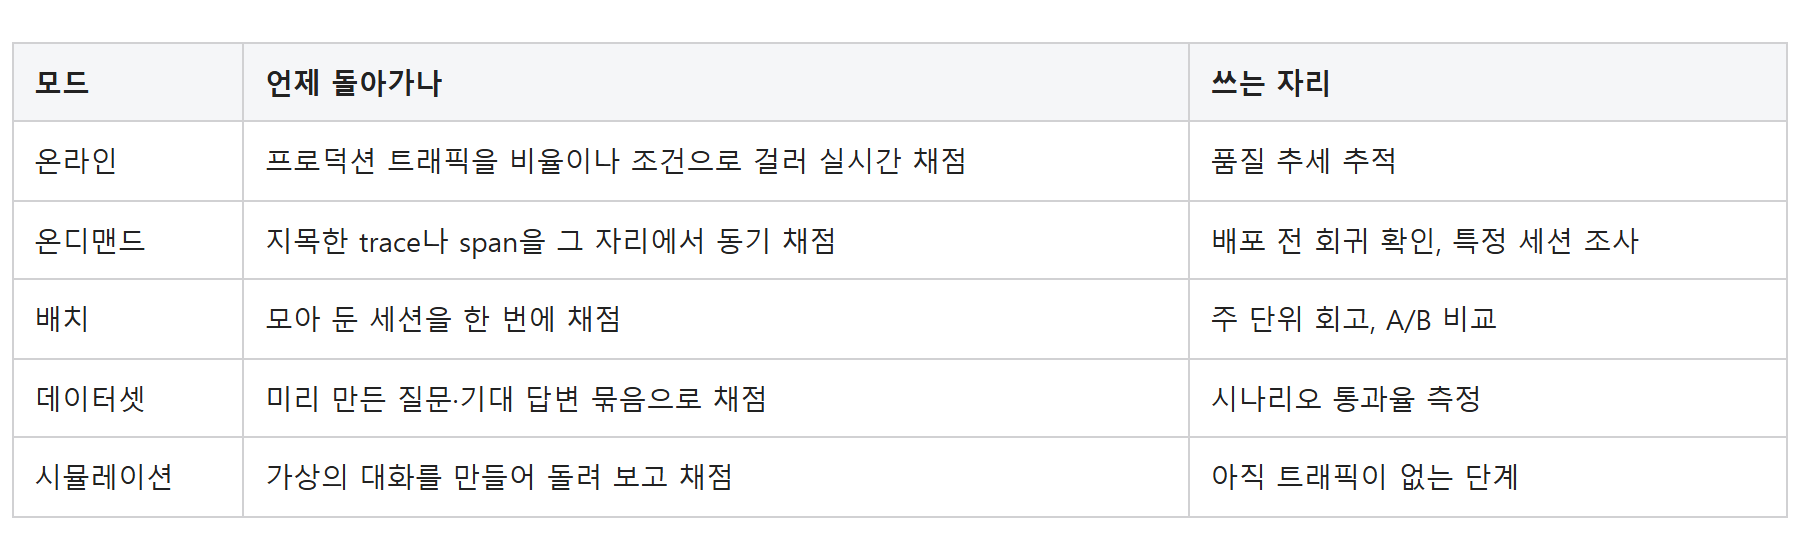
온라인 모드는 평가 구성을 만들어 두고 켜 둡니다. 구성에 데이터 소스, 샘플링 규칙, 평가자 목록, 실행 역할이 들어가고, 만들 때 바로 켤지를 함께 정합니다. 반면 온디맨드는 구성을 두지 않고 호출할 때마다 평가자와 대상을 넘깁니다. 동기 호출이라 응답에 점수와 설명이 바로 담겨 돌아옵니다. 대상은 레벨에 맞춰 지목합니다. TRACE 레벨 평가자에는 trace 식별자를, TOOL_CALL 레벨 평가자에는 span 식별자를 넘깁니다.
결과는 AgentCore Observability로 들어갑니다. 7편에서 CloudWatch에 지연과 토큰을 모아 두었는데 품질 점수가 같은 자리에 붙습니다. 지표를 따로 옮겨 붙이지 않아도 한 대시보드에서 "느려졌는가"와 "나빠졌는가"를 함께 봅니다.
Bedrock Evaluations 쪽을 쓸 일도 있습니다. 모델을 갈아 끼울 때 어느 모델이 이 도메인에 맞는지 비교하는 작업이 그렇습니다. 그때는 평가 작업(evaluation job)을 만들고 결과가 S3에 JSON Lines로 쌓입니다. 작업이 비동기라 상태가 완료로 바뀔 때까지 기다려야 결과를 꺼낼 수 있고, 작업이 쓰는 IAM 역할의 신뢰 정책 Principal은 bedrock.amazonaws.com입니다. 에이전트 전체가 아니라 모델을 비교하는 자리라는 것만 구분하면 됩니다.
3. 내장 평가자와 커스텀 평가자 — 언제 무엇을 고르나
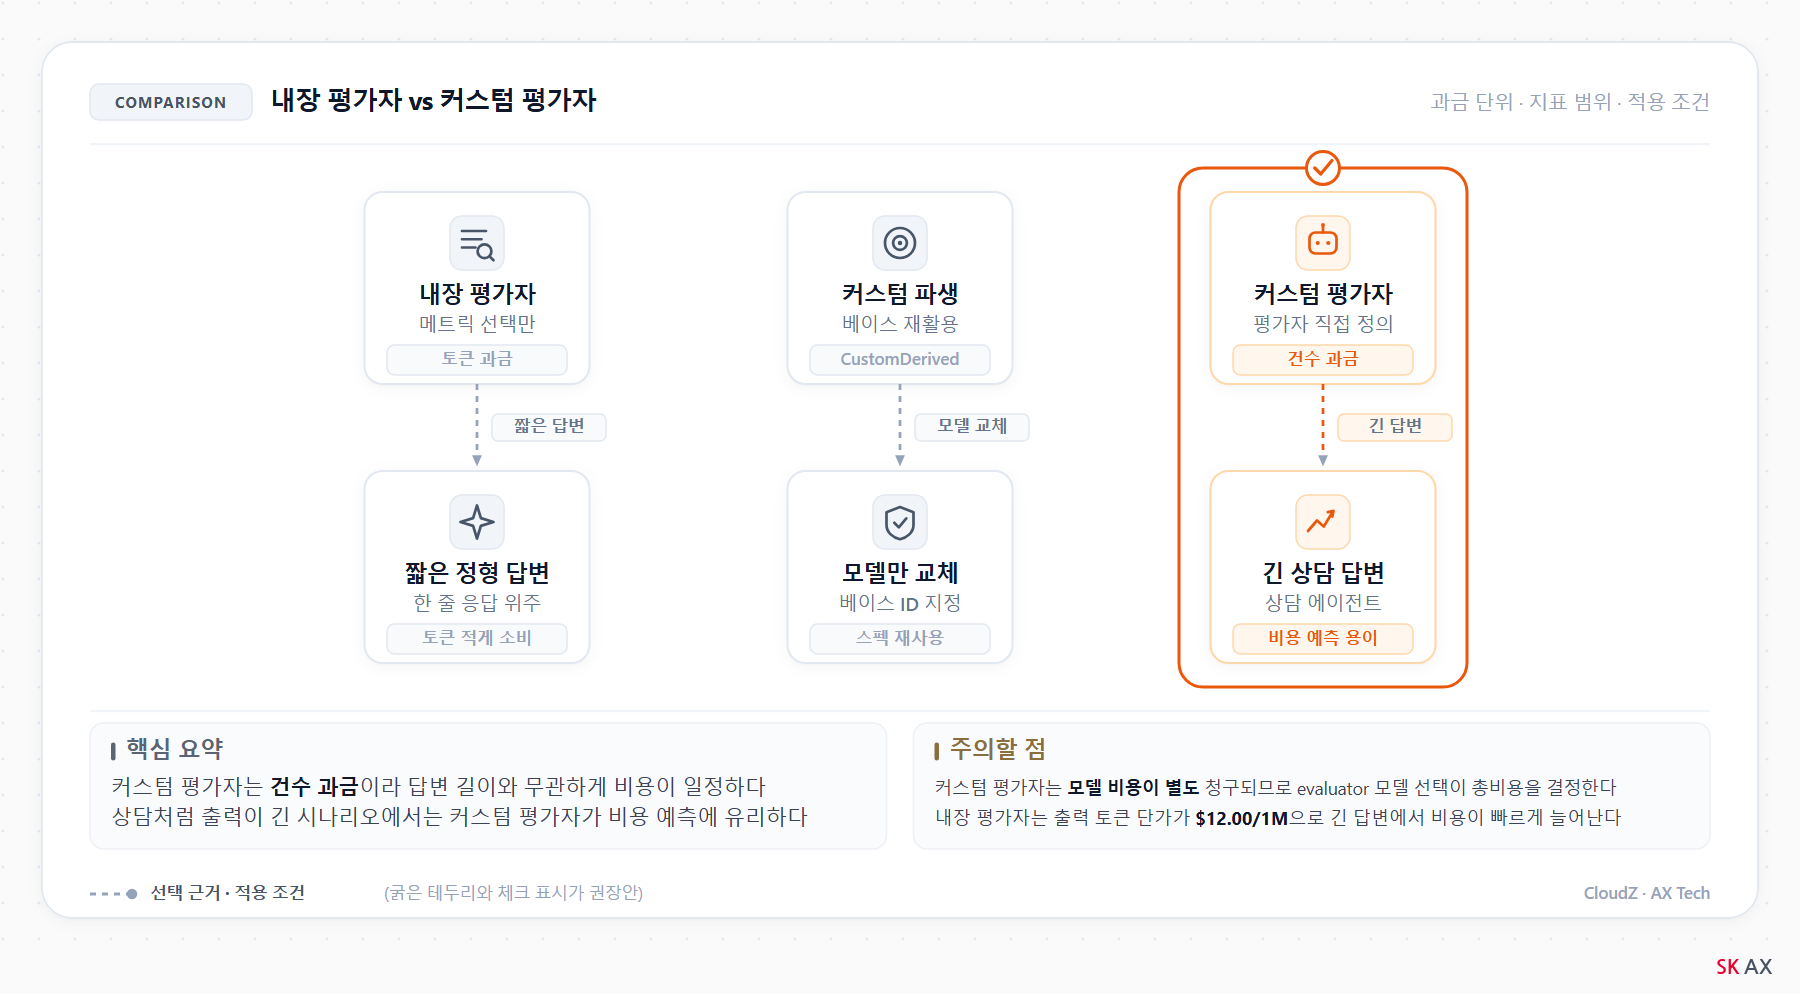
[그림 2] 내장 평가자와 커스텀 평가자 비교 — 적용 조건, 비용, 지표 범위
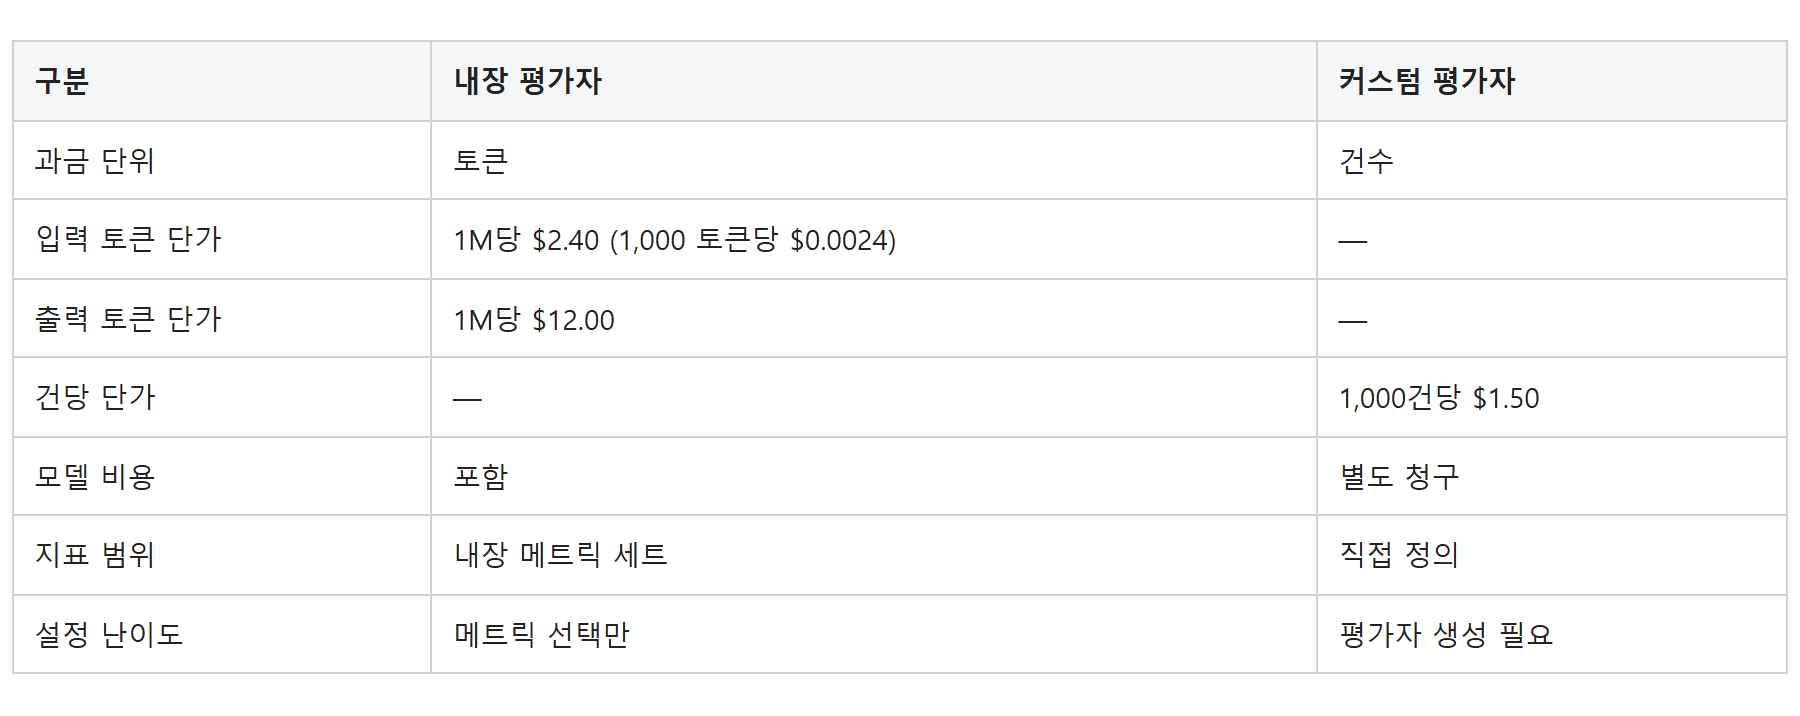
내장 평가자는 메트릭을 고르기만 하면 바로 쓸 수 있어서 시작이 빠릅니다. 그러나 토큰 단위로 과금되므로 답변이 길어질수록 비용이 늘어납니다. 상담 에이전트처럼 환불 절차를 단계별로 안내하는 답변은 출력 토큰이 많이 나옵니다.
커스텀 평가자 1,000건 비용인 $1.50으로 내장 평가자 출력 토큰을 환산하면 어떻게 될까요. 출력 토큰 단가가 1,000 토큰당 $0.012이므로 $1.50은 출력 토큰 125,000개에 해당합니다. $1.50을 1,000 토큰당 단가로 나눈 뒤 1,000을 곱한 값입니다.
커스텀 평가자는 건당 과금이므로 응답이 길어져도 플랫폼 비용이 늘지 않습니다. 답변 길이가 들쭉날쭉한 상담 시나리오에서는 이 특성이 비용 예측을 쉽게 만들어 줍니다.
상담 에이전트라면 커스텀 평가자를 권장합니다. 다만 커스텀 평가자는 별도로 모델 비용이 붙으므로 어떤 모델을 evaluator로 쓰느냐에 따라 총비용이 달라집니다.
내장 평가자가 맞는 경우도 있습니다. 답변이 짧고 정형화된 시나리오, 예를 들어 "주문 상태: 배송 중"처럼 한 줄 답변이 대부분인 경우에는 토큰이 적게 나가므로 내장 평가자의 간편함이 이깁니다.
커스텀 파생 평가자(derived 유형)는 기존 평가자를 베이스로 삼아 모델만 바꿉니다. evaluatorConfig의 derived 멤버에 baseEvaluatorId와 modelConfig를 지정하며, instructions와 ratingScale은 베이스 평가자가 소유하므로 따로 지정하지 않습니다. evaluatorType은 CustomDerived로 설정됩니다.
커스텀 평가자를 만들 때 넘기는 필수 입력은 평가자 이름, 평가자 설정, 레벨 셋입니다. 레벨은 2절에서 짚은 TOOL_CALL·TRACE·SESSION 가운데 하나이고 빼면 만들어지지 않습니다. 파생 평가자도 레벨은 직접 정합니다. 베이스가 소유하는 것은 지시문과 평점 척도까지입니다.
4. 사람 수정량을 지표로 쓰는 이유
자동 점수는 "모델이 보기에 괜찮은 답변"을 측정합니다. 그런데 모델이 괜찮다고 한 답변을 고객이 받아들이지 못하는 경우가 있습니다. "환불 처리 완료까지 3~5 영업일 소요됩니다"라는 답변은 사실이고 문법도 맞지만, 고객이 "그래서 지금 내 돈은 어디 있느냐"고 다시 물어온다면 그 답변은 실패입니다.
이 간극을 잡는 지표가 사람 수정량입니다. 10편에서 사람이 끼어드는 자리를 만들었는데, 그것은 고액 환불을 승인하거나 거부하는 단계였습니다. 답변 자체를 검토하는 자리는 아직 없습니다. 그 자리를 하나 더 두는 것이 이 지표의 전제입니다. 상담원이 에이전트 답변을 보고 그대로 보내면 수정량은 0이고, 문장을 고쳐 보내면 1 올라갑니다. 이 비율을 주 단위로 추적하면 자동 점수가 잡지 못하는 품질 변화가 드러납니다. 10편의 승인 워크플로와 같은 콜백 구조를 쓰면 검토 자리도 같은 방식으로 붙습니다.
두 지표는 서로 다른 것을 봅니다. 자동 점수는 "답변이 질문에 맞는가"를 보고, 사람 수정량은 "답변이 고객에게 통하는가"를 봅니다. 자동 점수가 높은데 수정량도 높다면 에이전트가 사실은 맞게 말하지만 말투나 구성이 고객 기대와 어긋난다는 뜻입니다. 이때는 프롬프트의 응답 형식 지시를 고칩니다. 반대로 자동 점수가 떨어지면서 수정량도 올라간다면 에이전트가 틀린 정보를 주고 있을 가능성이 높고, 도구나 Knowledge Bases 쪽을 먼저 살핍니다.
주 단위 회고에서 두 지표를 나란히 놓으면 판단이 갈립니다. 자동 점수가 유지되는데 수정량만 오르면 프롬프트 형식을 점검합니다. 둘 다 나빠지면 도구 응답이나 Knowledge Bases 문서가 바뀌었는지를 먼저 봅니다. 자동 점수는 올랐는데 수정량이 그대로라면 평가가 보는 범위가 실제 문의 분포와 어긋나 있을 수 있으므로, 샘플링 조건이나 데이터셋 모드의 묶음을 갱신합니다. 이 세 갈래가 회고의 출발점이 됩니다.
5. 점수를 회고에 연결하는 방법
점수가 떨어졌을 때 "에이전트가 나빠졌다"로 끝내면 아무것도 고칠 수 없습니다. 점수 하락의 원인을 분류하고 개선 대상을 특정하는 흐름이 필요합니다.
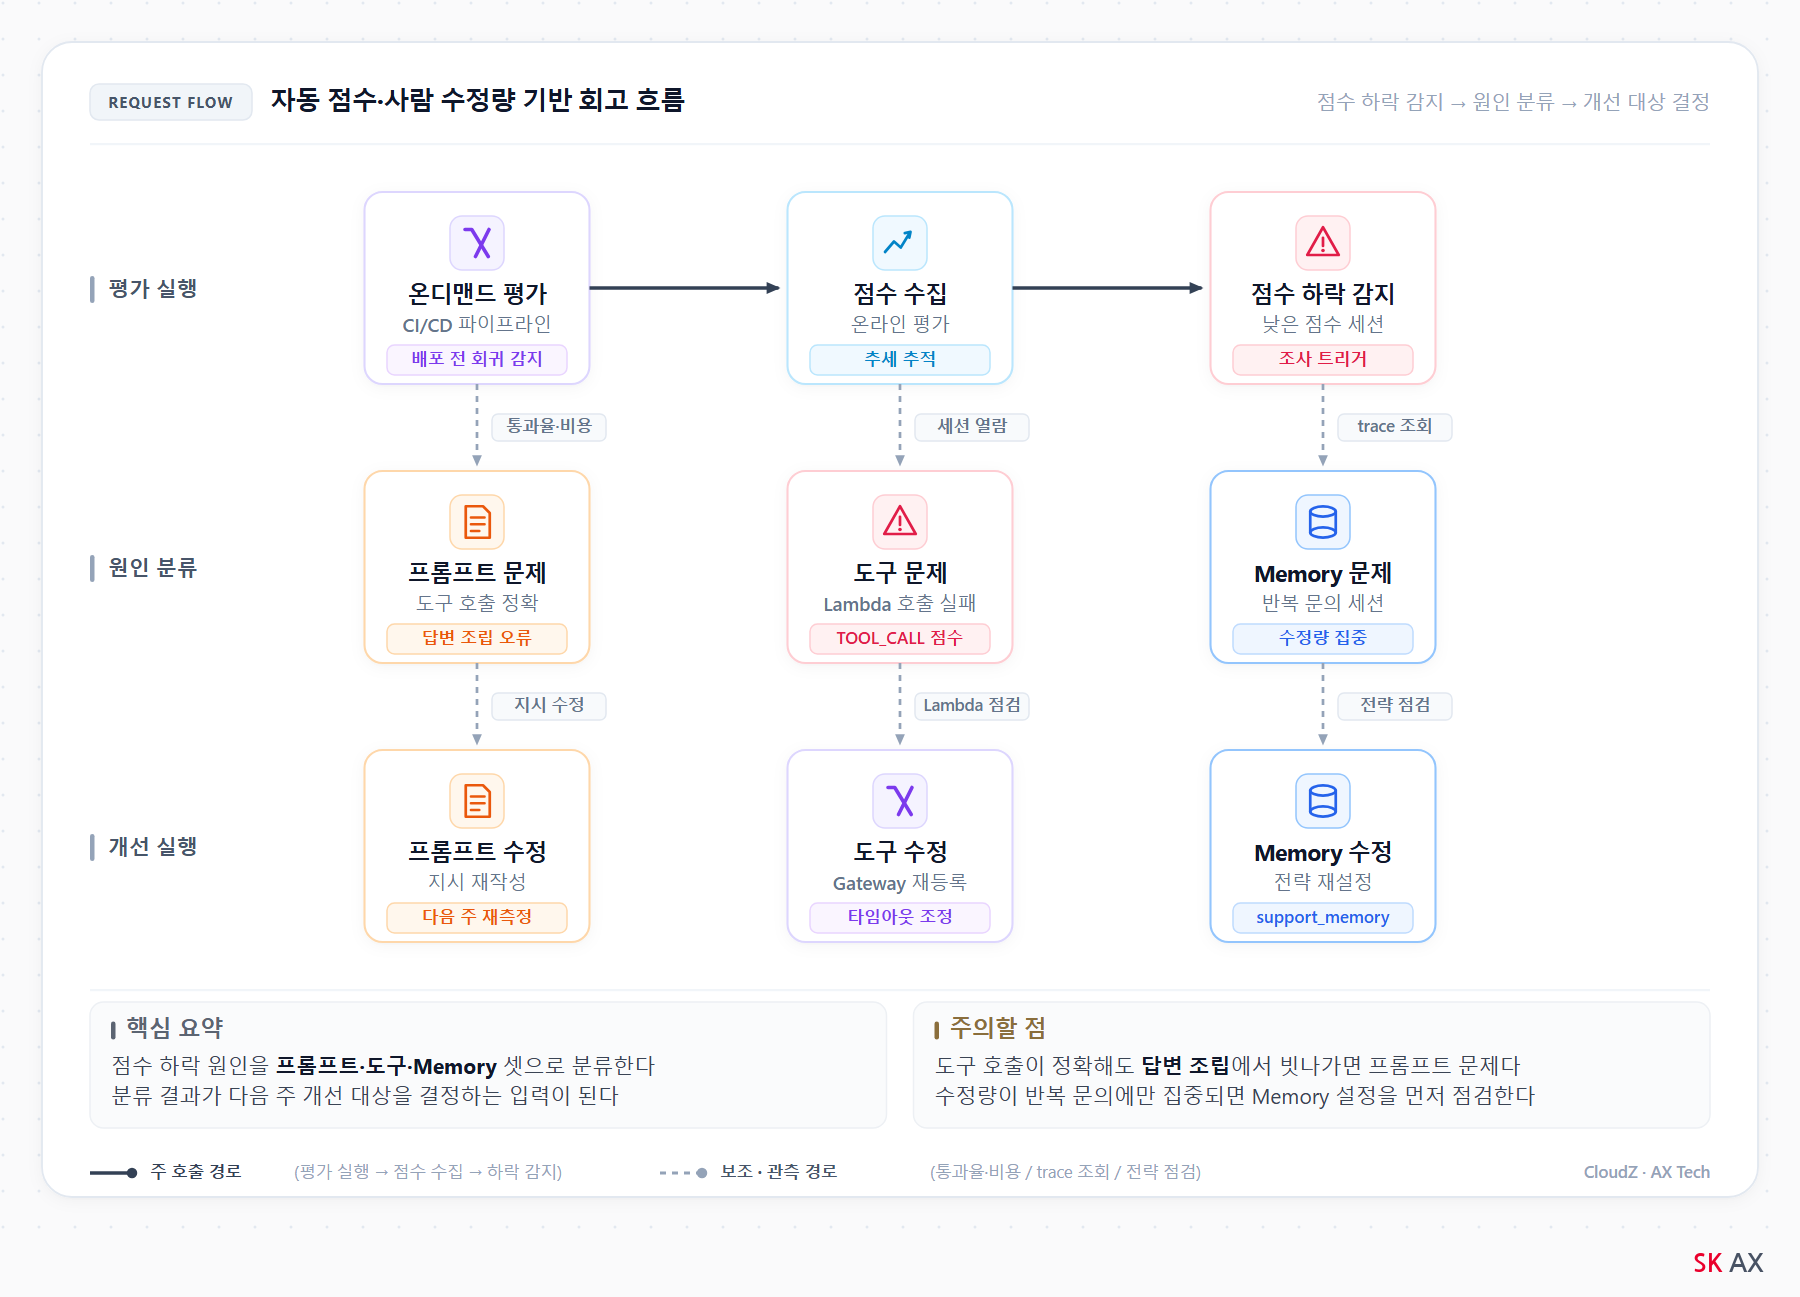
[그림 3] 자동 점수와 사람 수정량을 함께 보는 회고 흐름 — 점수 하락 감지에서 원인 분류, 개선 대상 결정까지
AWS가 권장하는 운영 패턴은 두 단계로 나뉩니다. CI/CD 파이프라인에서 온디맨드 평가를 돌려 배포 전에 품질 회귀를 잡고, 프로덕션에서는 온라인 평가를 걸어 품질 추세를 추적하다가 점수가 떨어지면 낮은 점수 세션을 조사합니다. CI/CD 단계에서는 시나리오별 통과율, 시나리오당 비용, 지연 시간을 함께 추적하는 것이 AWS 권장 방식입니다.
회고에서 원인을 분류하는 기준은 이렇습니다.
프롬프트 문제인지 먼저 봅니다. 자동 점수가 떨어졌는데 도구 호출 자체는 정확하다면, 에이전트가 정보를 가져오는 데는 성공했지만 그것을 답변으로 조립하는 과정에서 빗나간 것입니다. 7편에서 구성한 Observability로 trace를 열어 도구 응답과 최종 답변을 비교하면 프롬프트의 어느 지시가 문제인지 좁힐 수 있습니다.
도구 문제는 호출 실패율로 드러납니다. 3편에서 Gateway에 등록한 주문 조회 Lambda가 타임아웃을 내거나 잘못된 값을 돌려주면 에이전트 답변도 틀어집니다. TOOL_CALL 레벨 평가자인 Builtin.ToolSelectionAccuracy를 함께 돌리고 있다면 어떤 도구에서 점수가 떨어졌는지 바로 보입니다.
Memory 문제는 반복 문의에서 나타납니다. 4편에서 설정한 support_memory가 지난 상담 맥락을 제대로 꺼내지 못하면, 같은 고객이 다시 왔을 때 이미 안내한 내용을 또 묻습니다. 사람 수정량이 반복 문의 세션에서만 높다면 Memory 설정을 먼저 점검합니다.
이 분류를 주 단위 회고에 넣으면 "이번 주는 프롬프트를 고치고 다음 주에 다시 재겠다"처럼 개선 주기가 돌아갑니다. 점수는 그 주기의 입력이고 출력은 구체적인 변경 사항입니다.
6. 운영 시 주의사항
온라인 평가의 샘플링 비율을 반드시 설정합니다. 내장 평가자를 쿼터 상한인 분당 100만 토큰으로 1시간 연속 실행하면 비용이 빠르게 불어납니다.
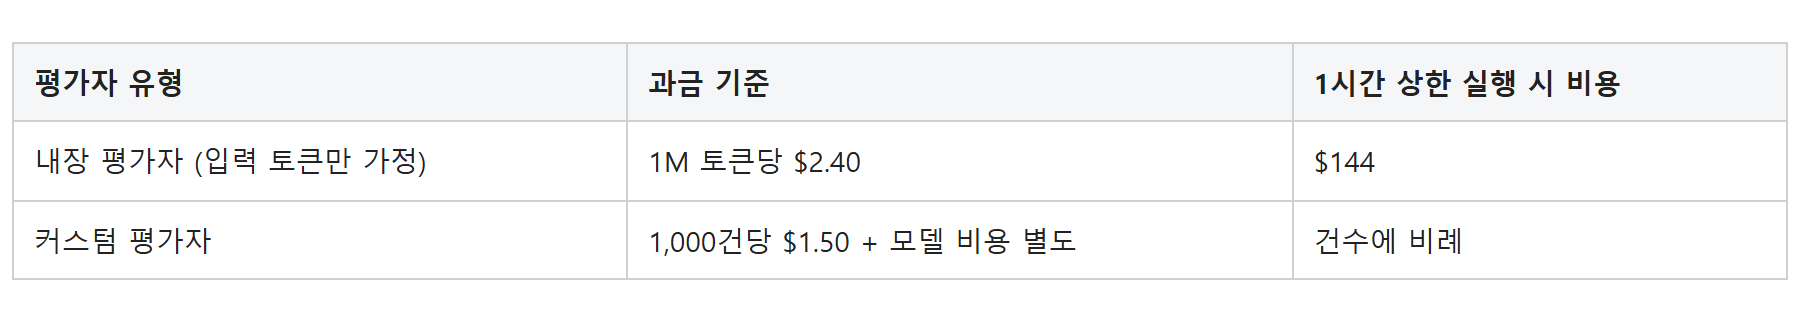
내장 평가자의 시간당 $144는 입력 토큰만으로 계산한 최솟값입니다. 분당 1,000,000 토큰에 60분을 곱하면 시간당 60,000,000 토큰이고, 1M당 $2.40이므로 60을 곱해 $144가 됩니다.
출력 토큰까지 더하면 실제 비용은 이보다 높아집니다. 전량 샘플링은 비용이 시간당 세 자릿수에 달하므로, 프로덕션에서는 트래픽의 일부만 걸러 평가하는 것이 비용 통제의 첫 단추입니다.
평가 구성 쿼터를 의식합니다. 리전당 평가 구성은 최대 1,000개입니다. 온라인 평가와 온디맨드 평가가 이 쿼터를 함께 씁니다. CI/CD 파이프라인마다 온디맨드 구성을 새로 만들면 프로덕션 온라인 평가 슬롯이 줄어듭니다. 에이전트·메트릭 단위로 구성을 재사용하는 명명 규칙을 잡아야 쿼터 소진을 막을 수 있습니다.
자동 점수를 절대 기준으로 삼지 않습니다. 자동 점수 0.85가 "좋다"는 뜻인지는 도메인마다 다릅니다. 환불 안내처럼 정확성이 생명인 시나리오에서 0.85는 나머지가 틀릴 수 있다는 뜻이고, 인사말 생성에서 0.85는 충분히 자연스럽다는 뜻일 수 있습니다. 점수의 절대값보다 추이를 봅니다. 지난주 0.85에서 이번 주 0.78로 떨어졌다면 무엇이 바뀌었는지 조사하는 것이 점수의 올바른 쓰임입니다.
평가가 보는 범위의 편향을 점검합니다. 온라인 모드의 샘플링 조건이 특정 유형의 문의만 걸러 내거나 데이터셋 모드의 묶음이 한쪽에 치우쳐 있으면, 다른 유형의 품질이 떨어져도 전체 점수에 거의 반영되지 않습니다. 실제 문의 비율에 맞춰 조건을 잡거나 시나리오별로 평가를 나눠 돌려야 약한 고리가 숫자에 드러납니다.
실행 역할을 경로에 맞게 겁니다. 온라인 평가 구성을 만들 때는 실행 역할 ARN이 필수 입력에 들어갑니다. 구성 이름, 샘플링 규칙, 데이터 소스, 실행 역할, 만들 때 바로 켤지 여부 다섯을 모두 넘겨야 구성이 만들어집니다. 한편 Bedrock 쪽 평가 작업을 돌릴 때는 그 작업이 쓰는 역할의 신뢰 정책 Principal.Service가 bedrock.amazonaws.com이어야 합니다. 다른 서비스 Principal을 넣으면 작업이 실행되지 않습니다. 두 경로가 쓰는 역할이 다르니 섞지 않습니다.
맺음말
열두 편에 걸쳐 한 겹씩 쌓아 올린 것은 쇼핑몰 상담 에이전트 하나입니다. 1편에서 AgentCore를 고른 이유를 따졌고, 2편부터 7편까지 Runtime 배포·도구 연결·기억·권한·비용·Observability를 차례로 쌓았습니다. 8편 이후로는 Code Interpreter·Knowledge Bases·사람 검토·Guardrails를 얹었습니다. 이번 12편의 Evaluations는 그 모든 것이 실제로 맞물려 돌아가는지 확인하는 마지막 고리입니다.
Evaluations를 도입할 조건은 분명합니다. 에이전트가 하루 수십 건 이상의 답변을 내놓고, 그 답변의 품질이 사업에 영향을 주는 상황이라면 자동 점수가 값을 합니다. 반대로 에이전트가 사내 소수 인원만 쓰고 답변을 사람이 매번 확인하는 구조라면 평가 파이프라인을 따로 세우는 것이 오히려 관리 부담만 늘립니다.
점수는 목적이 아니라 도구입니다. 0.85를 0.90으로 올리는 것 자체가 목표가 되면 데이터셋을 점수에 맞춰 조정하는 함정에 빠집니다. 점수가 떨어졌을 때 프롬프트를 고칠지, 도구를 고칠지, Memory를 고칠지 판단하는 데 쓰는 것이 점수의 올바른 자리입니다. 그 판단이 돌아가기 시작하면 에이전트는 배포한 뒤에도 계속 나아집니다.
이것으로 연재를 마칩니다. 열두 편이 하나의 에이전트를 함께 만들어 온 여정이었습니다. 어느 편이든 다시 펼쳐서 그 편의 구조를 여러분의 에이전트에 대입해 보시기 바랍니다.
참고 자료
- Amazon Bedrock AgentCore Pricing — 내장 평가자와 커스텀 평가자의 토큰·건당 단가가 정리되어 있습니다.
- Amazon Bedrock AgentCore Evaluations 개발자 가이드 — 평가 구성 쿼터와 분당 토큰 한도가 나와 있습니다.
- Amazon Bedrock Model Evaluation Report (S3) — 결과 파일의 JSON Lines 형식과 필드 구조가 담겨 있습니다.
- Amazon Bedrock LLM-as-judge 평가 방식 — generator model과 evaluator model의 역할 분담이 정리되어 있습니다.
- AgentCore 커스텀 파생 평가자 가이드 — 파생 평가자의 evaluatorConfig 구성 방식이 나와 있습니다.
- CreateEvaluationJob API Reference — 모델 평가 작업의 필수 필드와, 직접 만든 응답을 채점할 때 쓰는 precomputedInferenceSource가 나와 있습니다.
- AgentCore 온디맨드 평가 시작하기 — 레벨별로 trace 식별자와 span 식별자를 어떻게 지목하는지 예시가 있습니다.
- Judge 모델 서비스 역할 — 평가 작업 IAM 역할의 신뢰 정책 Principal이 명시되어 있습니다.
- Operational Reliability — AgentCore 운영 권장 사항 — CI/CD 온디맨드 평가와 프로덕션 온라인 평가의 권장 패턴이 정리되어 있습니다.